




4 Fähigkeitsmodell und Testdimensionen
Dieses Kapitel ordnet die Testfälle der data2type LLM Testsuite nach den Fähigkeiten, die mit ihnen untersucht werden. Neben fachlicher und standardbezogener Kompetenz werden semantische Fähigkeiten, Robustheit gegenüber Repräsentationen, formale Ausgabequalität und operative Eigenschaften betrachtet.
Warum ein Fähigkeitsmodell notwendig ist
Eine lange Liste von Dateiformaten beschreibt noch nicht, was ein Modell können muss. Die LLM Testsuite ordnet Aufgaben deshalb nach Fähigkeiten und nutzt Formate, Standards und Domänen als Testgegenstände.
Das Fähigkeitsmodell besteht aus drei Hauptdimensionen und mehreren Querschnittsdimensionen.
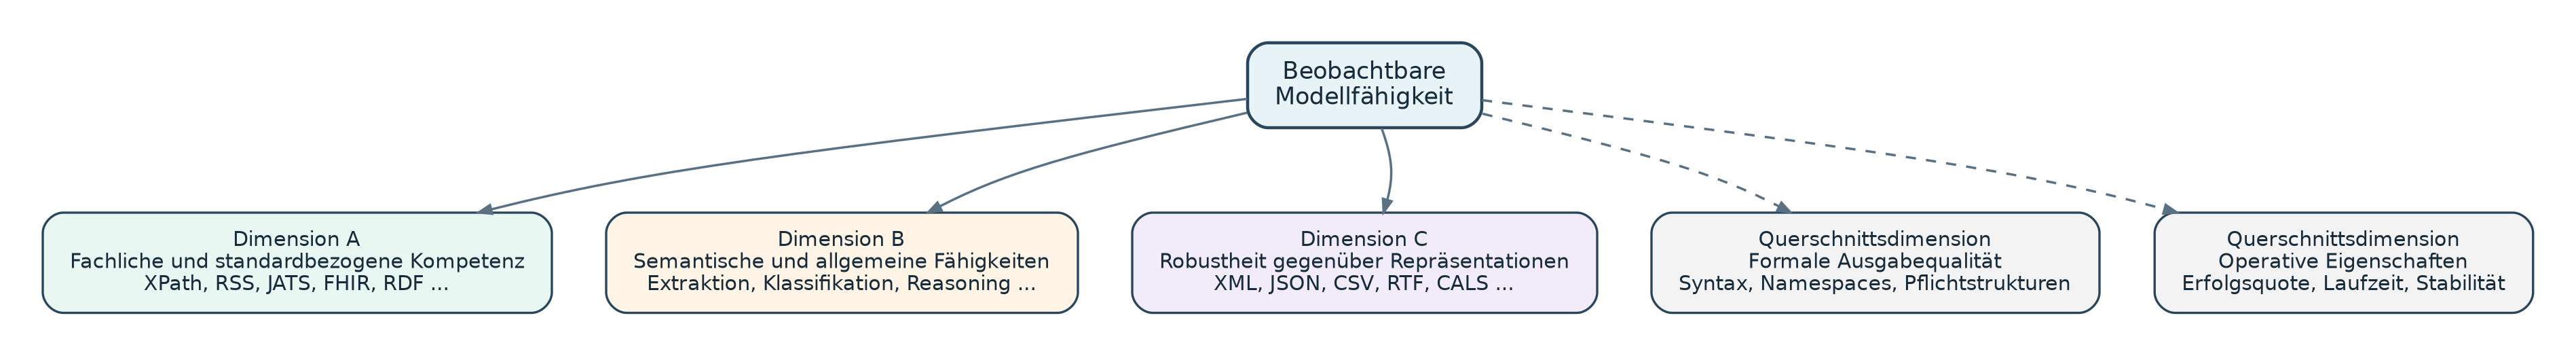
Abbildung: Fachliche Kompetenz, semantische Fähigkeiten und Repräsentationsrobustheit bilden die Hauptdimensionen. Formale Ausgabequalität und operative Eigenschaften werden querschnittlich betrachtet.
Dimension A: Fachliche und standardbezogene Kompetenz
Diese Dimension prüft, ob ein Modell einen technischen oder fachlichen Gegenstand praktisch anwenden kann.
Dazu gehören unter anderem:
| Bereich | Beispiele |
|---|---|
| XML-Sprachen | XPath, XSLT, XSD, Schematron |
| Publishing-Standards | JATS, BITS, DITA, DocBook, TEI, NISO STS |
| Metadaten | Dublin Core, MARC21, LOM |
| Web und Syndikation | RSS, Atom, XHTML, SSML |
| Wissensrepräsentation | RDF/XML, Turtle, XBRL |
| Lerntechnologien | QTI, DITA Learning and Training |
| Gesundheit | FHIR, ICD-11, HFIR-bezogene Strukturen |
Standardkenntnis ist mehrstufig. Ein Modell kann einen Begriff erklären, ein minimales Beispiel erzeugen oder eine vollständige, valide Struktur mit korrekten Namespaces, Versionen und Pflichtbestandteilen erstellen. Testfälle sollten diese Stufen getrennt erfassen.
Dimension B: Semantische und allgemeine Fähigkeiten
Diese Dimension untersucht Fähigkeiten, die nicht an ein einzelnes Format gebunden sind.
| Fähigkeit | Typische Aufgabe |
|---|---|
| Extraktion | Einen Wert, eine Person, einen Ort oder eine Literaturangabe finden |
| Klassifikation | Einen Fall einer Kategorie oder einem Code zuordnen |
| Strukturverständnis | Hierarchien, Tabellenköpfe, Fußnoten oder Referenzen korrekt zuordnen |
| Regelanwendung | Mehrere Bedingungen ausführen und ein Zielergebnis berechnen |
| Entity Recognition | Personen, Orte, Organisationen oder Identifikatoren erkennen |
| Transformation | Inhalt in ein gefordertes Zielvokabular überführen |
| Instruktionsbefolgung | Ausschließlich die verlangte Ausgabe erzeugen |
| Mehrsprachigkeit | Inhalte und Originalschreibungen in mehreren Schriftsystemen erhalten |
Die LLM Testsuite kann dieselbe semantische Fähigkeit in mehreren Repräsentationen prüfen. Dadurch lässt sich unterscheiden, ob ein Fehler eher aus der Aufgabenlogik oder aus der Darstellung entsteht.
Dimension C: Robustheit gegenüber Repräsentationen
Diese Dimension betrachtet, wie stabil eine Fähigkeit bei veränderter Darstellung bleibt.
Beispiele sind:
- Komma gegenüber Semikolon in CSV,
- eingerücktes gegenüber kompaktem XML,
- HTML-Kopfzellen mit
tdgegenüberth, - einfache gegenüber überspannten Tabellen,
- kurzer gegenüber langem Kontext,
- Text gegenüber XML, JSON, YAML oder Markdown,
- CSV gegenüber XLSX, HTML, WordML oder RTF,
- lateinische gegenüber nichtlateinischen oder rechts-nach-links geschriebenen Inhalten.
Robustheit ist kein Zusatzmerkmal. In Produktionssystemen entscheidet sie darüber, ob ein Prozess nur mit einer sorgfältig vorbereiteten Eingabe oder auch mit heterogenen Quelldaten funktioniert.
Querschnittsdimension: Formale Ausgabequalität
Viele Aufgaben sind nur dann nutzbar, wenn die Ausgabe maschinenverarbeitbar ist. Die fachlich richtige Information kann trotzdem unbrauchbar sein, wenn das Modell zusätzliche Erklärungen, Markdown-Codeblöcke oder ungültige XML-Strukturen ausgibt.
Die formale Qualität umfasst unter anderem:
- Syntax und Wohlgeformtheit,
- korrekte Namespaces,
- Standardversionen,
- Pflichtstrukturen,
- exakte Feldnamen,
- erlaubte Zusatzinformationen,
- Einhaltung eines geforderten Antwortformats.
Querschnittsdimension: Operative Eigenschaften
Ein Modell kann fachlich geeignet, aber operativ ungeeignet sein. Deshalb erfasst die LLM Testsuite zusätzlich:
- technische Erfolgsquote,
- Timeouts und leere Antworten,
- Median der Laufzeit,
- P95 der Laufzeit,
- Antwortlänge,
- Schwankung über Wiederholungen,
- Unterschiede nach Ausführungsweg.
Diese Kennzahlen sind keine fachlichen Fähigkeiten, beeinflussen aber die Einsatzentscheidung.
Kategorien als mehrdimensionale Tags
Testfälle können mehrere Kategorien besitzen. Ein Test zu einer überspannten CALS-Tabelle kann gleichzeitig den Kategorien xml, cals und table zugeordnet sein. Eine JATS-Aufgabe zur Literaturerkennung kann xml, jats, semantics, multilingual und nonlatin kombinieren.
Mehrfachkategorien ermöglichen flexible Auswertungen, erzeugen aber keine disjunkten Gruppen. Bei einer Summe über Kategorien kann derselbe Run mehrfach enthalten sein. Kategorien sind daher Filter und Perspektiven, keine additive Gesamtzerlegung.
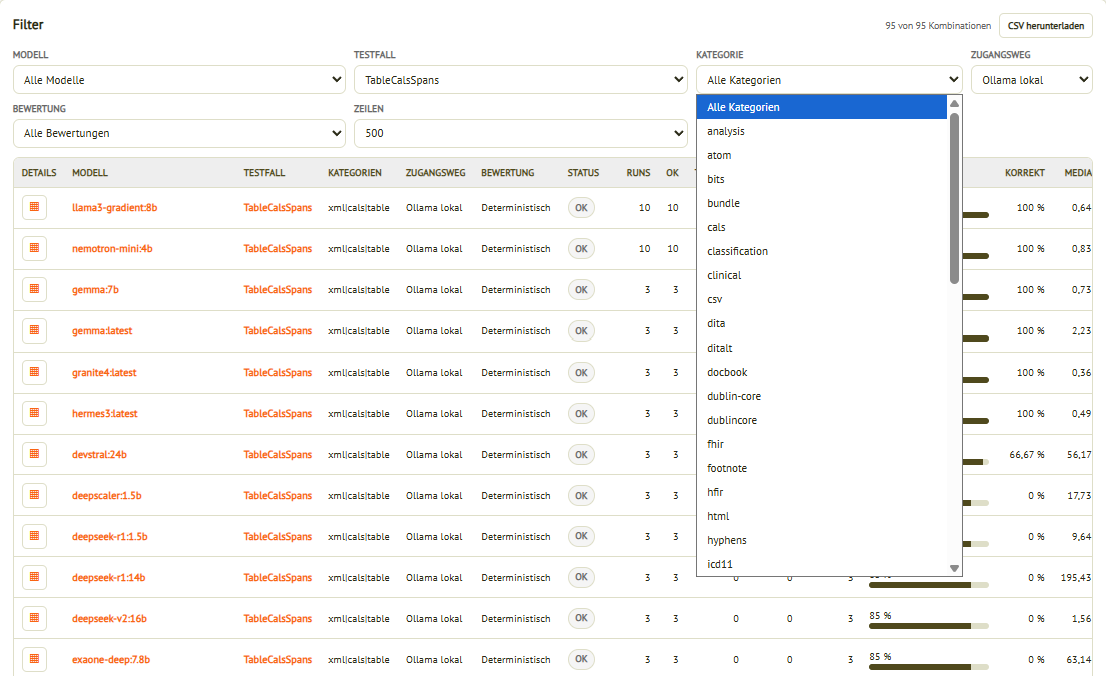
Abbildung: Der Kategorien-Filter im LLM Testsuite Dashboard zeigt die mehrdimensionale Taxonomie. Kategorien beschreiben Domäne, Format, Fähigkeit oder Aufgabencharakter und können gemeinsam an einem Testfall auftreten.
Die Kategorien dienen auch als Suchraum für neue Fragestellungen. Ein Nutzer kann beispielsweise alle Tests mit semantics, alle Tests mit fhir oder alle Kombinationen aus xml und table betrachten.
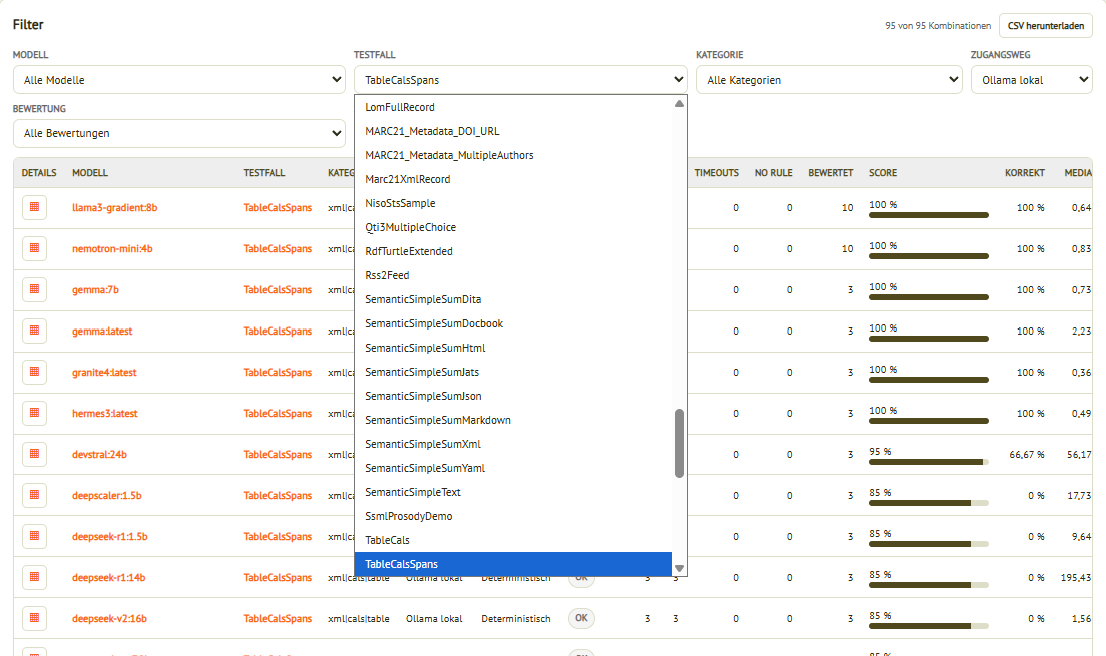
Abbildung: In der Testfall-Ansicht im LLM Testsuite Dashboard kann die Ergebnismatrix auf eine Kategorie eingegrenzt werden. Dadurch entstehen fähigkeitsspezifische Vergleiche statt einer einzigen globalen Rangliste.
Zukünftige Fähigkeiten
Das Fähigkeitsmodell ist offen. Neue Testreihen können Fähigkeiten aufnehmen, die heute noch nicht oder nur teilweise abgedeckt sind. Dazu zählen beispielsweise:
- XPath 3.0 und XPath 3.1 mit Sequenzen, Maps, Arrays und Funktionen,
- XQuery 3.1,
- XSLT 3.0 mit Streaming, Packages oder Higher-Order Functions,
- Schematron QuickFix (SQF),
- SPARQL und SHACL,
- Tool-Nutzung und strukturierte Funktionsaufrufe,
- agentische Abläufe mit mehreren Schritten,
- Validierung und Selbstkorrektur,
- RAG-Aufgaben mit kontrolliert variierten Chunk-Strategien.
Ein neuer Test sollte immer benennen, welche Fähigkeit er misst, welche Störfaktoren vorhanden sind und welche Bewertung die Aussage trägt.
Kompetenzstufen innerhalb eines Standards
Die Kenntnis eines Standards ist keine binäre Eigenschaft. Für viele Standards lassen sich mindestens fünf Stufen unterscheiden:
| Stufe | Beobachtbare Leistung |
|---|---|
| Begriffswissen | Das Modell kann Zweck und Grundbegriffe erklären. |
| Strukturerkennung | Das Modell erkennt typische Elemente, Attribute und Beziehungen. |
| Minimale Erzeugung | Das Modell erzeugt ein einfaches, plausibles Beispiel. |
| Konforme Anwendung | Das Modell erfüllt Pflichtstrukturen, Namespaces und fachliche Vorgaben. |
| Komplexe Anwendung | Das Modell löst verschachtelte, mehrteilige oder versionsspezifische Aufgaben zuverlässig. |
Ein Modell, das ein minimales RSS-Beispiel erzeugt, beherrscht damit noch nicht automatisch alle relevanten Varianten. Ebenso ist die Erzeugung eines wohlgeformten JATS-Dokuments nicht gleichbedeutend mit semantisch korrekter wissenschaftlicher Auszeichnung. Testreihen sollten diese Stufen sichtbar machen.
Wissen, Transformation und Validierung
Bei technischen Aufgaben sind drei Teilfähigkeiten zu unterscheiden:
- Wissen betrifft die Kenntnis von Begriffen und Regeln.
- Transformation betrifft die Fähigkeit, konkrete Eingaben in eine geforderte Struktur zu überführen.
- Validierung betrifft die Fähigkeit, Fehler zu erkennen und gegebenenfalls zu korrigieren.
Diese Teilfähigkeiten können bei demselben Modell unterschiedlich ausgeprägt sein. Ein Modell kann eine korrekte Erklärung zu XPath 3.1 geben, aber einen ungeeigneten Ausdruck erzeugen. Es kann ein XML-Dokument generieren, aber einen vorhandenen Namespace-Fehler übersehen. Künftige Testserien sollen diese Rollen gezielt trennen.
Fähigkeitsprofile für Anwendungsszenarien
Aus den Dimensionen entsteht kein einzelnes universelles Kompetenzmaß, sondern ein Profil. Für ein RAG-System sind möglicherweise semantische Extraktion, Repräsentationsrobustheit und Laufzeit wichtig. Für eine XML-Generierung stehen Standardkonformität, Validierbarkeit und Instruktionsbefolgung im Vordergrund. Für eine Recherche-Aufgabe können Mehrsprachigkeit und Entitätserkennung entscheidend sein.
Das LLM Testsuite Dashboard soll deshalb ermöglichen, aus einer allgemeinen Ergebnismenge anwendungsspezifische Perspektiven zu bilden. Eine Organisation kann die für sie relevanten Kategorien auswählen und Modelle innerhalb dieser Teilmenge vergleichen. Die Research Notes können solche Profile exemplarisch demonstrieren, ohne sie als allgemeingültige Rangliste auszugeben.
Wechselwirkungen zwischen Dimensionen
Die Dimensionen wirken nicht unabhängig voneinander. Eine semantisch korrekte Extraktion kann an der formalen Ausgabevorgabe scheitern. Eine standardkonforme Struktur kann inhaltlich falsche Werte enthalten. Eine robuste Repräsentationsverarbeitung kann auf Kosten der Laufzeit gehen.
Deshalb werden fachliche, formale und operative Kennzahlen getrennt gespeichert. Erst ihre gemeinsame Betrachtung erlaubt eine realistische Einschätzung der Produktionstauglichkeit.