




7 Bewertungsverfahren für Modell-Antworten
Dieses Kapitel erläutert, wie Modell-Antworten in der data2type LLM Testsuite bewertet werden. Es trennt technische Fehler von fachlicher Qualität und beschreibt deterministische Prüfungen, semantische Bewertung durch einen LLM-Judge, hybride Verfahren sowie Maßnahmen zur Qualitätssicherung.
Grundsatz
Eine Bewertung muss zur Aufgabe passen. Ein einzelner Zahlenwert kann exakt geprüft werden. Ein vollständiges JATS-Dokument besitzt dagegen viele mögliche korrekte Ausprägungen. Eine medizinische Klassifikation folgt anderen Kriterien als ein RSS-Feed oder eine semantische Literaturauszeichnung.
Die LLM Testsuite verwendet deshalb mehrere Bewertungsebenen:
- technische Klassifikation,
- deterministische fachliche Bewertung,
- optionale semantische Bewertung durch einen LLM-Judge,
- manuelle Stichproben und Qualitätskontrollen.
Technische Klassifikation
Vor jeder fachlichen Bewertung wird geprüft, ob ein Run technisch verwertbar ist.
| Status | Bedeutung |
|---|---|
ok |
technisch erfolgreiche Antwort |
timeout |
Zeitlimit überschritten |
api_error |
API- oder HTTP-Fehler |
non_success_return_code |
nicht erfolgreicher Rückgabe-Code |
empty_output |
Antwort nach Bereinigung leer |
done_reason_* |
abweichender provider-bezogener Abschlussgrund |
Ein technischer Fehler erhält im effektiven Score den Wert 0. Der fachliche Score bleibt dabei leer, weil keine inhaltliche Bewertung stattgefunden hat. Diese Trennung verhindert, dass technische Ausfälle als semantisch falsche Antworten ausgegeben werden.
Deterministische Bewertung
Deterministische Regeln sind vorzuziehen, wenn die korrekte Lösung eindeutig oder formal prüfbar ist. Das aktuelle Regelsystem unterstützt unter anderem:
| Modus | Prinzip |
|---|---|
| Erwartungswert | normalisierter Vergleich mit einem Sollwert |
| Alle Muster | alle geforderten regulären Ausdrücke müssen vorkommen |
| Pflichtstrukturen | Anteil gefundener Struktur-Elemente |
| Spezielle Entscheidungslogik | testfallspezifische Auswertung komplexer Antwortmuster |
Mögliche weitere deterministische Prüfer sind XML-Parser, JSON-Parser, XPath, XSD, Schematron, RDF-Parser oder domänenspezifische Validatoren. Entscheidend ist, dass die Regel versioniert, getestet und verständlich dokumentiert wird.
Exakt, enthalten und partiell
Ein Sollwerttest kann verschiedene Stufen unterscheiden. Eine Antwort kann exakt dem Ziel entsprechen, den Zielwert mit zusätzlichem Text enthalten oder nur teilweise passende Strukturen liefern. Solche Abstufungen sind nützlich, dürfen aber nicht verdecken, ob eine strikte Ausgabe-Anweisung verletzt wurde.
Wenn ein Prompt „nur die Zahl“ verlangt, kann eine inhaltlich richtige Erklärung für einen automatisierten Prozess dennoch unbrauchbar sein. Inhaltstreffer und Instruktionsbefolgung sollten deshalb bei Bedarf getrennt ausgewiesen werden.
LLM-Judge
Ein LLM-Judge bewertet Antworten, für die mehrere korrekte Formen möglich sind oder deren semantische Qualität nicht vollständig durch einfache Regeln beschrieben werden kann.
Der Judge erhält mindestens:
- Testfall-ID und Kategorien,
- Beschreibung der Aufgabe,
- erwartete Antwort oder Zielbeschreibung,
- optionale Muss- und Ausschlusskriterien,
- die konkrete Modell-Antwort.
Die erwartete Judge-Antwort ist ein strukturiertes JSON-Objekt mit Label, Score, kurzer Begründung sowie gefundenen und fehlenden Punkten.
Judge-Labels
Das konfigurierte Schema unterscheidet typischerweise:
| Label | Bedeutung |
|---|---|
correct |
fachlich vollständig korrekt |
mostly_correct |
im Wesentlichen korrekt, kleinere Mängel |
partial |
relevante Teile vorhanden, wesentliche Lücken |
wrong |
fachlich falsch oder strukturell unbrauchbar |
not_answered |
Aufgabe nicht beantwortet |
judge_error |
Urteil technisch oder formal nicht verwertbar |
Judge-Label und numerischer Score werden separat gespeichert. Dadurch bleiben Inkonsistenzen sichtbar. Ein System darf eine Divergenz zwischen Label und Score nicht stillschweigend als gültiges Urteil übernehmen.
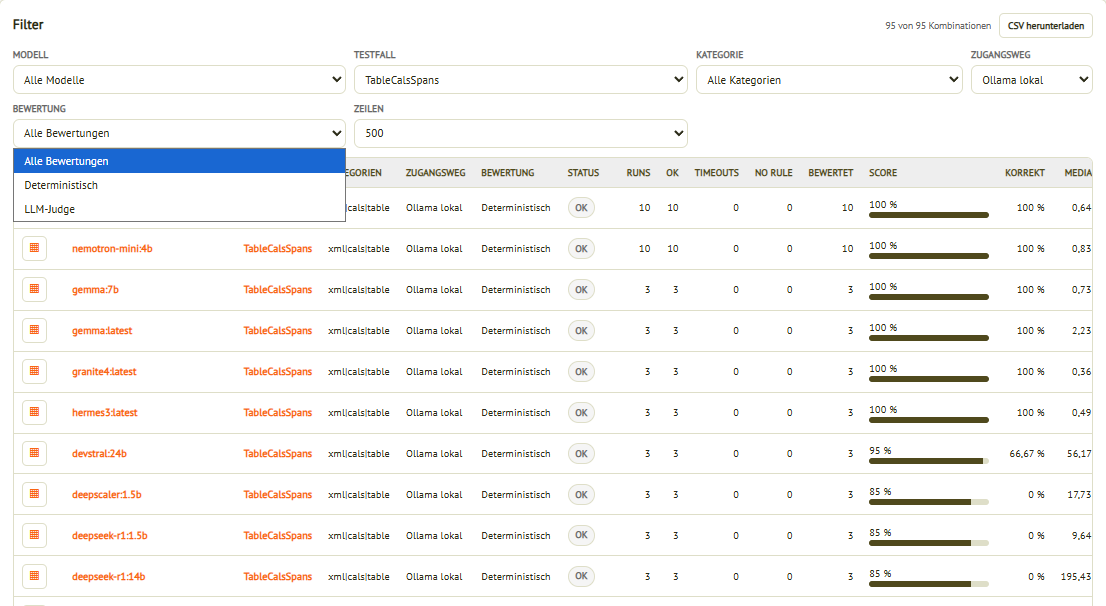
Abbildung: Die Modell-Testfall-Ansicht im LLM Testsuite Dashboard trennt deterministische Bewertung und LLM-Judge. Dies macht sichtbar, auf welcher methodischen Grundlage ein Score entstanden ist.
Cache und Versionierung des Judges
Semantische Bewertungen können teuer und zeitaufwendig sein. Der Judge verwendet deshalb einen Cache. Der Cache-Key berücksichtigt Testfall, erwartete Antwort, Erwartungshinweise, Modell-Antwort, Judge-Modell, Prompt-Version und Rubrikversion.
Ändert sich einer dieser Bestandteile, entsteht ein neuer Key. So wird verhindert, dass ein Urteil aus einer älteren Rubrik unbemerkt wiederverwendet wird.
Transparenz der Einzelurteile
Ein Judge-Score allein ist nicht ausreichend. Die Begründung zeigt, welche Kriterien das Urteil getragen haben. Judge-Einzelansichten erlauben außerdem die Kontrolle von Cache-Nutzung, Judge-Modell und Label.
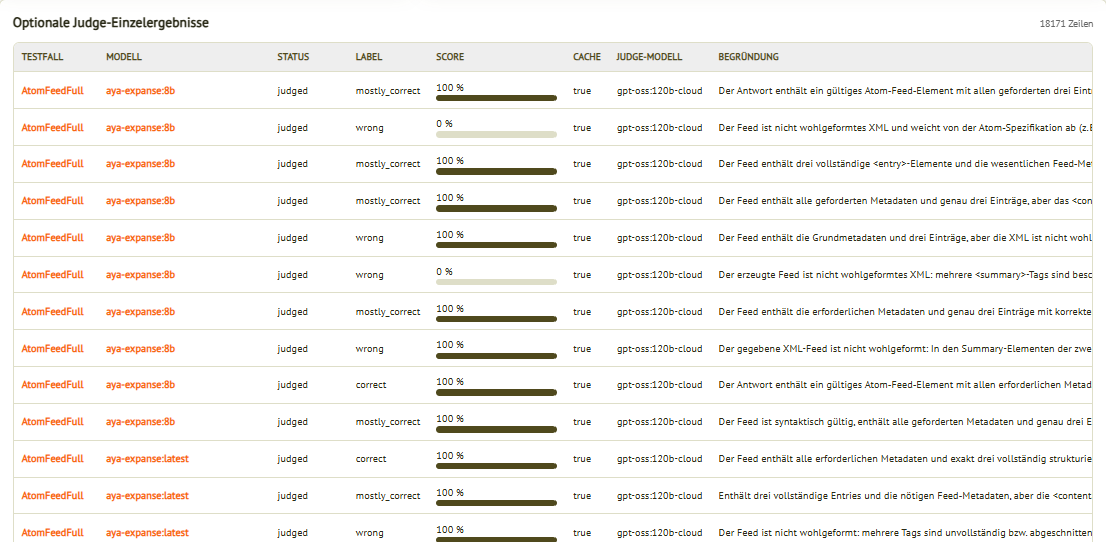
Abbildung: Die Tabelle stellt Testfall, Modell, Status, Label, Score, Cache, Judge-Modell und Begründung nebeneinander. Sichtbare Divergenzen zwischen Label und Score sind als Bewertungsanomalien zu prüfen, nicht als normale Ergebnisse zu interpretieren.
Hybride Bewertung
Für komplexe strukturierte Ausgaben ist eine hybride Bewertung besonders geeignet.
Beispiel für einen JATS-Artikel:
- XML-Wohlgeformtheit deterministisch prüfen.
- Namespace und Root-Element deterministisch prüfen.
- Pflichtstrukturen per XPath oder Schema prüfen.
- Übernommene Metadaten deterministisch vergleichen.
- semantische Angemessenheit verbleibender Freitexte durch Judge bewerten.
Die deterministische Ebene übernimmt objektiv prüfbare Kriterien. Der Judge bewertet nur den Teil, der tatsächlich semantische Interpretation erfordert.
Fehlende Regeln
Ein Test ohne Regel wird als no_rule gekennzeichnet. Er darf nicht in den Nenner eines fachlichen Scores eingehen, solange keine Bewertung stattgefunden hat. Gleichzeitig bleibt der Run für technische Analysen und spätere Neubewertungen erhalten.
Diese Architektur erlaubt, neue Testfälle früh auszuführen und Bewertungsregeln anschließend kontrolliert zu entwickeln. Für öffentliche Rankings sollte jedoch klar ausgewiesen werden, welche Tests bereits fachlich bewertet sind.
Qualitätssicherung des Judges
Ein LLM-Judge ist kein neutraler Automat. Seine Urteile können von Modell, Rubrik, Prompt-Formulierung, Kontextlänge und Antwortreihenfolge abhängen. Die folgenden Maßnahmen sind deshalb notwendig:
- niedrige Temperatur und strukturierte Ausgabe,
- feste Prompt- und Rubrikversion,
- manuelle Stichproben,
- Vergleich mit deterministisch prüfbaren Teilkriterien,
- Wiederholungsprüfung bei kritischen Testfällen,
- Prüfung auf Label-Score-Inkonsistenzen,
- getrennte Ausweisung von Judge-Fehlern,
- Neubewertung nach Rubrikänderungen.
Ein Judge erweitert die Bewertungsmöglichkeiten, hebt die Grenzen probabilistischer Bewertung aber nicht auf.
Hierarchie der Prüfverfahren
Die Bewertung folgt möglichst einer Hierarchie vom eindeutigsten zum interpretativsten Verfahren. Zunächst wird geprüft, ob überhaupt eine technisch verwertbare Antwort vorliegt. Danach folgen Syntax und Parser-Prüfungen, exakte Sollwerte, strukturbezogene Regeln und erst anschließend semantische Beurteilungen.
Eine mögliche Reihenfolge lautet:
- technischer Status,
- Bereinigung und Extraktion der eigentlichen Antwort,
- Syntaxprüfung,
- Schema oder Strukturprüfung,
- exakte Werte und Pflichtinhalte,
- semantische Vollständigkeit,
- qualitative Bewertung durch einen Judge oder fachliche Stichprobe.
Diese Reihenfolge verhindert, dass ein LLM-Judge ein ungültiges XML-Dokument aufgrund seines plausiblen Inhalts zu positiv bewertet.
Externe Validatoren und Parser
Wo offizielle oder etablierte technische Prüfmittel existieren, sollten sie genutzt werden. XML kann auf Wohlgeformtheit geprüft werden. XSD, Schematron oder RELAX NG können strukturelle Regeln bewerten. RDF-Serialisierungen können geparst, JSON-Dokumente validiert und XPath-Ausdrücke mit einem passenden Prozessor ausgeführt werden.
Der Einsatz solcher Validatoren erhöht die Nachvollziehbarkeit. Er hat jedoch ebenfalls Grenzen. Ein Dokument kann schema-valide und semantisch falsch sein. Umgekehrt kann eine fachlich akzeptable Variante an einer zu engen Regel scheitern. Validatoren werden daher als Teil einer kombinierten Bewertung verstanden.
Falsch positive und falsch negative Bewertungen
Jede Regel kann Fehlentscheidungen erzeugen. Eine zu großzügige Textsuche kann eine falsche Antwort als Treffer akzeptieren. Eine zu strenge Exaktprüfung kann eine korrekte Antwort mit zusätzlichem Whitespace ablehnen. Ein Judge kann relevante Elemente übersehen oder stilistische Präferenzen mit fachlichen Kriterien verwechseln.
Für neue Bewertungsregeln werden deshalb Beispielantworten in mehreren Klassen gesammelt. Dazu gehören eindeutig korrekte, teilweise korrekte, falsche und formal problematische Ausgaben. Die Regel wird gegen diese Beispiele geprüft, bevor sie in eine veröffentlichte Aggregation eingeht.
Menschliche Stichproben
Auch bei automatisierter Bewertung bleiben manuelle Stichproben wichtig. Sie dienen nicht dazu, jeden Run erneut zu bewerten, sondern die Funktionsfähigkeit der Regeln zu prüfen. Besonders relevant sind Grenzfälle, sehr hohe oder sehr niedrige Scores, neue Modellfamilien und Testfälle mit unerwarteten Verteilungen.
Eine Stichprobe sollte dokumentieren, welche Auswahlmethode verwendet wurde. Zufällige Auswahl, risikobasierte Auswahl und gezielte Prüfung von Uneinigkeiten zwischen Regel und Judge erfüllen unterschiedliche Zwecke.
Änderungen an Bewertungsregeln
Wird eine Regel verändert, können sich Scores ändern, obwohl die zugrunde liegende Modell-Antwort gleich bleibt. Deshalb besitzen Regeln und Judge-Rubriken eigene Versionen. Bei wesentlichen Änderungen wird der betroffene Datenstand neu bewertet und als neuer Build veröffentlicht.
Ältere Research Notes behalten ihre Aussage für den damaligen Stand. Eine aktualisierte Regel kann Anlass für einen neuen Beitrag sein, der die Abweichung erklärt. So bleiben methodische Entwicklung und Ergebnisentwicklung unterscheidbar.