




3 Methodik und Grundkonzept
Dieses Kapitel beschreibt das methodische Grundprinzip der data2type LLM Testsuite. Es zeigt, was untersucht wird, wie Testläufe aufgebaut sind, wie kontrollierte Vergleiche entstehen und wie sich einzelne Ergebnisse bis auf konkrete Runs zurückverfolgen lassen.
Untersuchungsgegenstand
Der Untersuchungsgegenstand ist das beobachtbare Verhalten eines Large Language Models in einem definierten Testfall. Die Testsuite macht keine Aussage über interne Gewichte, Trainingskorpora oder verborgene Repräsentationen. Sie misst, welche Antwort unter dokumentierten Bedingungen erzeugt wird und wie diese Antwort bewertet werden kann.
Die kleinste Beobachtungseinheit ist ein einzelner Run. Ein Run verbindet mindestens:
- einen Testfall,
- einen Promptstand,
- ein Modell und eine Modellvariante,
- einen Ausführungsweg,
- eine Wiederholungsnummer,
- einen technischen Status,
- eine Modellantwort,
- eine fachliche Bewertung, sofern eine Regel verfügbar ist,
- eine Laufzeit.
Alle höheren Auswertungen entstehen durch Aggregation dieser Runs.
End-to-End-Ablauf
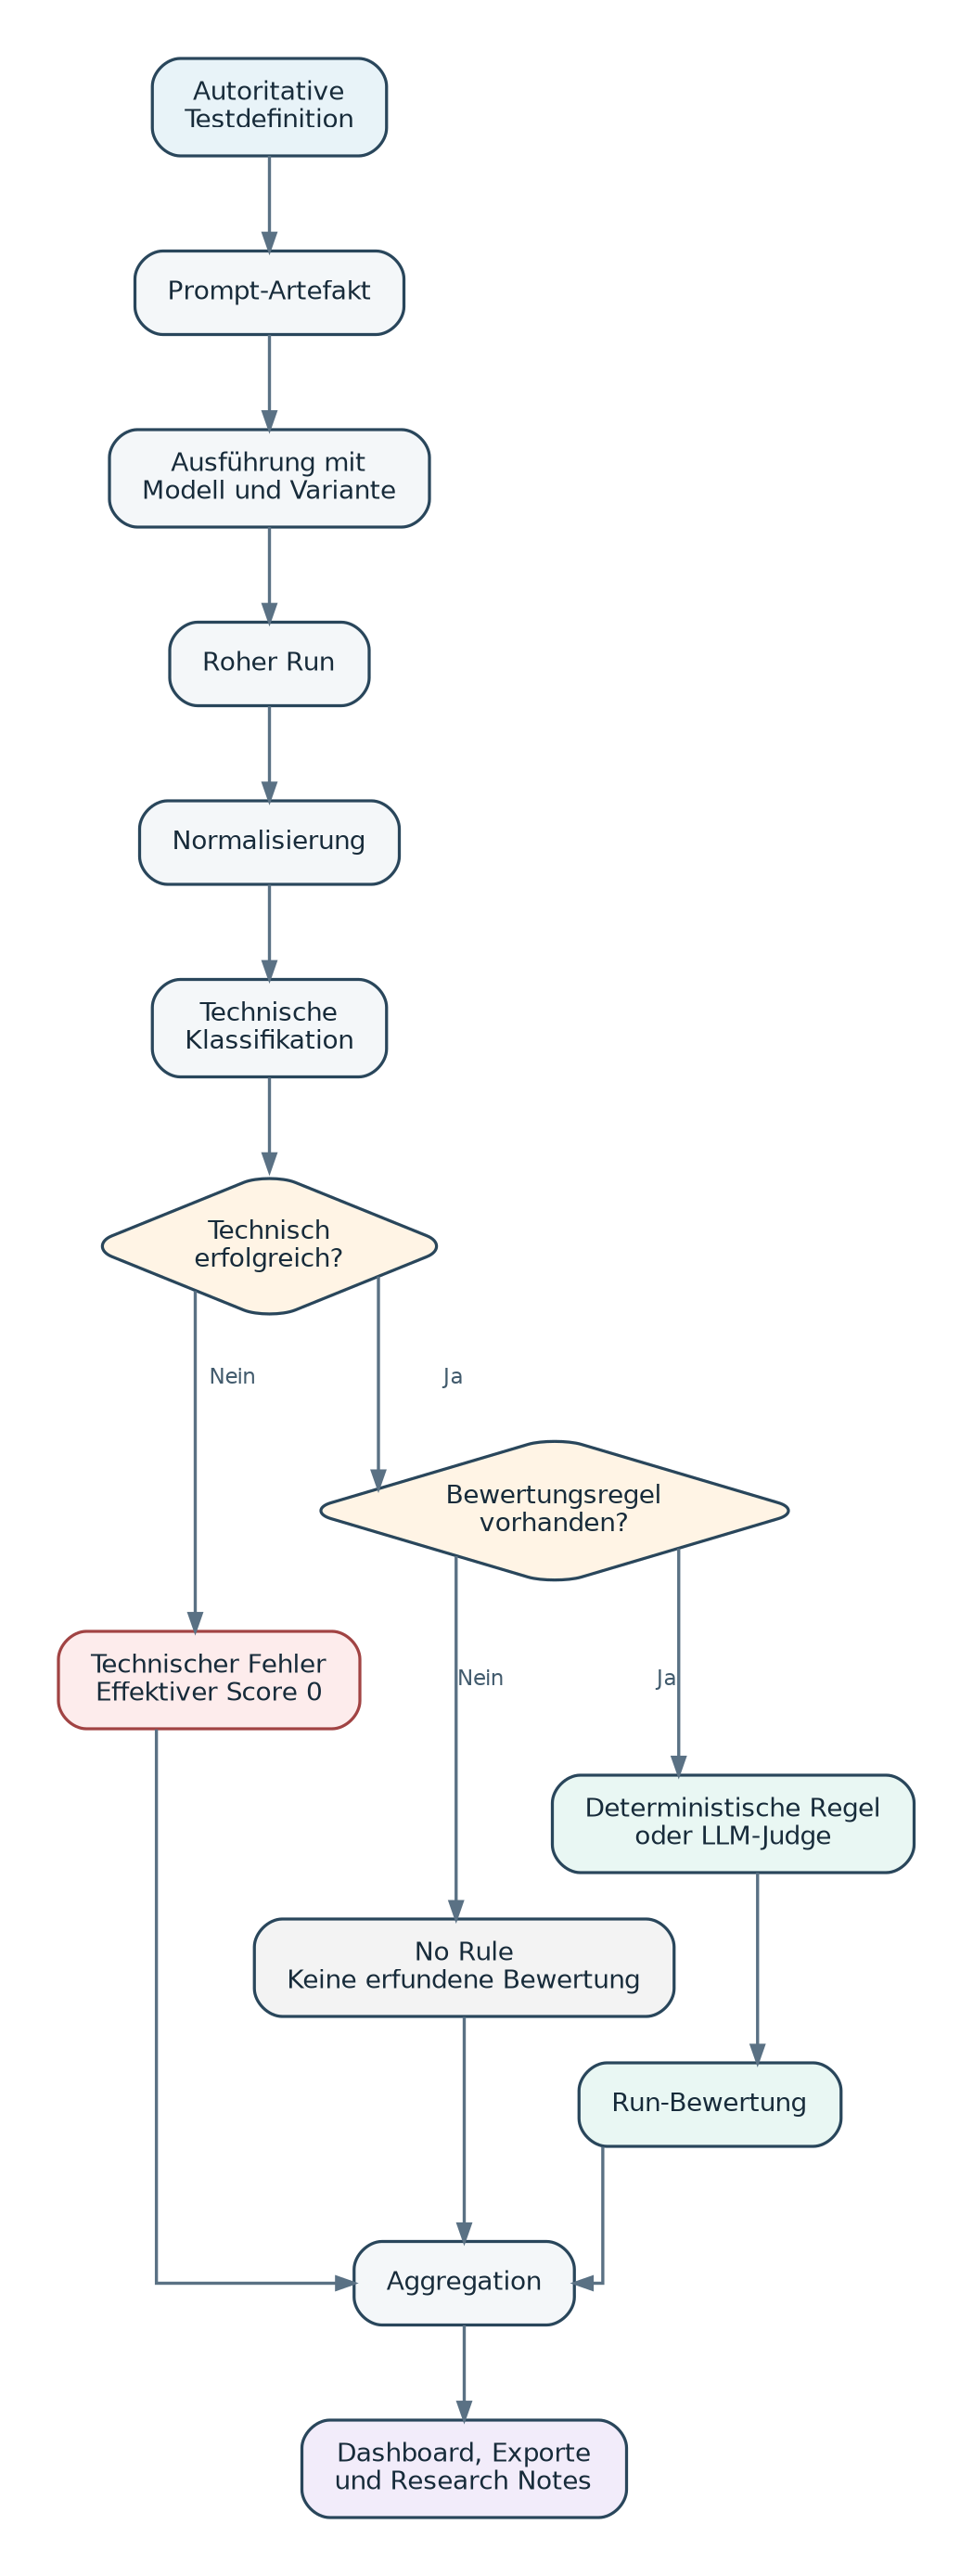
Abbildung: Ein Run wird zunächst technisch klassifiziert. Nur technisch erfolgreiche Antworten werden fachlich bewertet. Fehlende Regeln bleiben als transparente Bewertungslücke sichtbar.
Der Ablauf trennt bewusst technische und fachliche Ebenen. Eine leere Antwort, ein Timeout oder ein fehlerhafter Rückgabecode ist kein semantischer Fehler. Umgekehrt kann eine technisch erfolgreiche Antwort fachlich falsch sein.
Vergleichsebenen
Die Daten werden auf mehreren Ebenen betrachtet.
| Ebene | Beispielhafte Aussage |
|---|---|
| Run | Die dritte Wiederholung war technisch erfolgreich und fachlich korrekt. |
| Modell und Testfall | Das Modell löste sieben von zehn Wiederholungen korrekt. |
| Testfall | Der Testfall unterscheidet stark zwischen Modellen. |
| Modell | Das Modell ist in bestimmten Kategorien stabil, in anderen nicht. |
| Kategorie | Modelle zeigen bei Tabellen andere Muster als bei Metadaten. |
| Ausführungsweg | Lokale und cloud-basierte Läufe unterscheiden sich in Laufzeit und Fehlerprofil. |
| Repräsentationsfamilie | Dieselbe Aufgabe wird in XML anders gelöst als in JSON oder Markdown. |
Diese Ebenen dürfen nicht unkontrolliert vermischt werden. Ein Modell-Score ist nur sinnvoll, wenn klar ist, welche Tests und welche bewerteten Runs in ihn eingehen.
Kontrollierte Variation
Besonders aussagekräftig sind Testfamilien, in denen nur ein Merkmal verändert wird. Beispiele sind:
- identischer Tabelleninhalt mit unterschiedlichem Trennzeichen,
- dieselbe semantische Aufgabe in Text, XML, JSON, YAML oder Markdown,
- ein strukturell identisches XML-Dokument mit und ohne Einrückung,
- dieselbe Datentabelle in CSV, HTML, Markdown, XLSX, WordML oder RTF,
- dieselbe FHIR-Aufgabe in XML, JSON und Turtle.
Solche Vergleiche helfen, den Einfluss der Repräsentation von der eigentlichen Aufgabenanforderung zu trennen. Vollständig isolieren lässt sich dieser Einfluss nur, wenn Inhalt, Instruktion, Schwierigkeitsgrad und Bewertungsregel tatsächlich äquivalent sind. Die Äquivalenz muss deshalb bei der Testkonzeption dokumentiert werden.
Wiederholte Ausführung
Sprachmodelle können bei identischen Eingaben unterschiedliche Antworten liefern. Eine einzelne Antwort zeigt daher nur, dass ein Ergebnis einmal aufgetreten ist. Mehrere Runs erlauben Aussagen über Stabilität.
Für automatisierte Prozesse ist insbesondere relevant:
- ob ein Modell immer antwortet,
- ob es wiederholt dieselbe fachliche Lösung erreicht,
- ob Formatfehler nur gelegentlich oder systematisch auftreten,
- ob Laufzeiten stark streuen,
- ob Timeouts einzelne Ausreißer oder ein wiederkehrendes Muster sind.
Die Anzahl der Wiederholungen kann je nach Testphase und Ausführungsweg variieren. Deshalb wird sie in jeder Aggregation ausgewiesen und nicht stillschweigend vereinheitlicht.
Bewertungsneutralität durch transparente Lücken
Nicht jeder Testfall besitzt sofort eine vollständige Bewertungsregel. Die LLM Testsuite kennzeichnet solche Fälle als no_rule, statt ihnen einen scheinbar objektiven Score zuzuweisen. Dieses Verhalten ist methodisch wichtig. Eine fehlende Bewertung ist eine Datenlücke und keine falsche Antwort.
Für Veröffentlichungen muss daher zwischen drei Mengen unterschieden werden:
- allen ausgeführten Runs,
- technisch erfolgreichen Runs,
- fachlich bewerteten Runs.
Nur so bleiben Nenner und Aussagekraft nachvollziehbar.
Deterministische und probabilistische Komponenten
Die Modell-Antwort ist probabilistisch. Teile der Auswertung können dagegen deterministisch sein. Ein exakter Zahlenwert, ein regulärer Ausdruck, ein Parser oder eine Schema-Validierung liefern unter identischen Eingaben dasselbe Ergebnis. Ein LLM-Judge ist ebenfalls ein Sprachmodell und kann trotz niedriger Temperatur variieren oder fehlerhaft urteilen.
Die Methodik bevorzugt daher deterministische Prüfungen, wenn die Aufgabenstellung sie zulässt. Der LLM-Judge kommt dort zum Einsatz, wo mehrere fachlich akzeptable Ausgaben möglich sind oder semantische Kriterien nicht ausreichend durch einfache Regeln erfasst werden.
Beispiel für eine vollständige Prüfkette
Beim Testfall TableCalsSpans erhält das Modell eine CALS-Tabelle und soll einen bestimmten Zahlenwert ausgeben. Die Prüfkette kann wie folgt aussehen:
- Der Testfall ist über eine eindeutige ID und einen Prompt-Hash identifiziert.
- Der Prompt wird mehreren Modellen bereitgestellt.
- Jedes Modell wird mehrfach ausgeführt.
- Timeouts und leere Antworten werden technisch klassifiziert.
- Erfolgreiche Antworten werden mit dem erwarteten Zahlenwert verglichen.
- Exakte oder enthaltene Treffer erhalten ein dokumentiertes Label und einen Score.
- Ergebnisse werden pro Run, Modell und Testfall aggregiert.
- Details bleiben bis zur einzelnen Antwort nachvollziehbar.
Dieses Prinzip gilt unabhängig davon, ob der Gegenstand eine Tabelle, ein XML-Standard, eine semantische Extraktion oder eine zukünftige XPath-Aufgabe ist.
Operationalisierung einer Fähigkeit
Eine Fähigkeit muss so beschrieben werden, dass aus ihr beobachtbare Kriterien entstehen. Die Aussage „das Modell kann RSS“ ist zu ungenau. Sie kann bedeuten, dass das Modell den Begriff erklärt, einen syntaktisch plausiblen Feed erzeugt, Pflichtfelder korrekt setzt, Datumswerte normgerecht formatiert oder einen vorhandenen Feed semantisch auswertet.
Für jeden Fähigkeitsbereich werden daher konkrete Operationen formuliert. Dazu gehören Eingabe, erwartete Verarbeitung, zulässige Ausgabeformen und Bewertungslogik. Eine umfassende Fähigkeit kann durch mehrere Testfälle mit unterschiedlichem Schwierigkeitsgrad abgedeckt werden. Erst das Muster dieser Testfälle erlaubt ein belastbareres Fähigkeitsprofil.
Testmatrix und Abdeckung
Die LLM Testsuite lässt sich als Matrix aus Modellen, Testfällen, Wiederholungen und Ausführungswegen verstehen. Nicht jede Zelle dieser Matrix muss zu jedem Zeitpunkt gefüllt sein. Gründe können Kontextgrenzen, fehlende Provider-Unterstützung, technische Ausfälle, Kosten oder ein schrittweiser Ausbau der Testreihen sein.
Für jede Auswertung ist deshalb die Abdeckung auszuweisen. Zwei Modelle sind nur dann unmittelbar vergleichbar, wenn die betrachteten Kennzahlen auf derselben oder einer methodisch äquivalenten Testmenge beruhen. Bei ungleicher Abdeckung sind Teilrankings, paarweise Vergleiche oder kategoriale Profile aussagekräftiger als eine globale Reihenfolge.
Störfaktoren und Vergleichbarkeit
Neben der beabsichtigten Testvariable können weitere Faktoren das Ergebnis beeinflussen. Dazu zählen:
- Promptlänge,
- Tokenisierung,
- Kontextfenster,
- Systemprompt,
- Antwortlimit,
- Temperatur,
- Providerfilter,
- Quantisierung,
- Hardware und
- Netzwerkbedingungen.
Die Methodik verfolgt deshalb zwei Ziele. Erstens sollen kontrollierbare Parameter dokumentiert und soweit möglich konstant gehalten werden. Zweitens sollen nicht kontrollierbare Unterschiede sichtbar bleiben. Ein cloud-basiertes Modell und ein lokal quantisiertes Modell können verglichen werden, aber die Interpretation muss berücksichtigen, dass nicht nur die Modell-Architektur variiert.
Rückverfolgbarkeit vom Diagramm bis zum Run
Jede veröffentlichte Kennzahl sollte sich auf die zugrunde liegenden Runs zurückführen lassen. Ein Balken im LLM Testsuite Dashboard ist eine Aggregation. Für die Prüfung muss er auf Modell, Testfall, Wiederholungen, technische Statuswerte, Bewertungsregel und Datenstand zurückführbar sein.
Diese Rückverfolgbarkeit ist besonders wichtig, wenn ein Ergebnis überraschend wirkt. Ein niedriger Score kann durch fachlich falsche Antworten entstehen, aber auch durch Timeouts, fehlende Regeln oder eine kleine Zahl bewerteter Läufe. Erst der Drilldown zeigt, welche Ursache tatsächlich vorliegt.