




10 Technische Architektur und Verfahrensablauf
Dieses Kapitel erläutert den technischen Ablauf der LLM Testsuite auf Verfahrensebene. Beschrieben werden Daten- und Verarbeitungsschritte von der Testdefinition bis zum LLM Testsuite Dashboard, ohne den internen Quellcode oder ausführbare Implementierungsdetails öffentlich bereitzustellen.
Ziel der technischen Beschreibung
Die technische Architektur wird in dieser Methodikstudie bewusst ausführlich erklärt. Leserinnen und Leser sollen nachvollziehen können, wie aus einer Testidee ein versionierter Testfall, aus einem Testfall mehrere Modellläufe und aus den Modellläufen bewertete, aggregierte und veröffentlichte Ergebnisse entstehen.
Diese Transparenz ist von einer Veröffentlichung des Quellcodes zu unterscheiden. Die Studie beschreibt Komponenten, Datenflüsse, Zustände, Bewertungsstufen und Qualitätskontrollen. Sie veröffentlicht jedoch keine internen Programme, Skripte, Befehle, Zugangsdaten oder betriebliche Konfigurationen.
Zwei verbundene Verarbeitungsketten
Die Architektur besteht aus zwei miteinander verbundenen Ketten:
| Verarbeitungskette | Aufgabe |
|---|---|
| Ausführung | Testdefinitionen in ausführbare Prompts überführen, Modelle ansprechen und einzelne Runs protokollieren |
| Auswertung und Veröffentlichung | Runs normalisieren, technisch klassifizieren, fachlich bewerten, statistisch aggregieren, prüfen und im LLM Testsuite Dashboard bereitstellen |
Die Trennung ist wichtig. Ein Modelllauf kann unabhängig von einer späteren Bewertungsregel gespeichert werden. Bewertungsregeln können verbessert und erneut auf vorhandene Antworten angewendet werden, ohne alle Modelle noch einmal auszuführen. Ebenso kann das Dashboard neu erzeugt werden, ohne neue Modell-Antworten anzufordern.
End-to-End-Kette
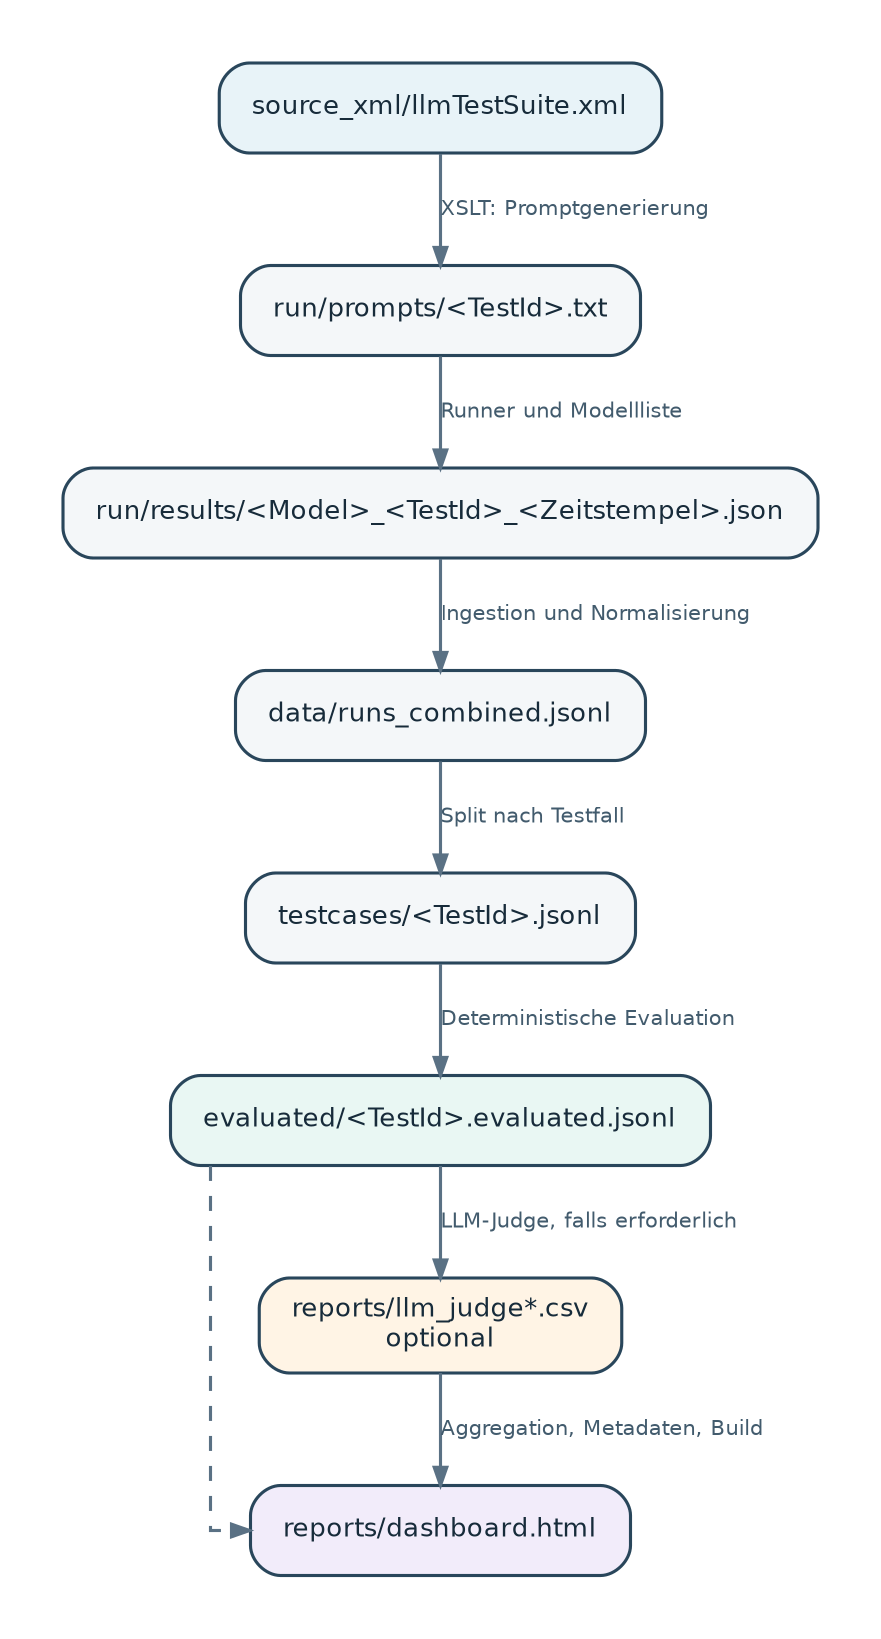
Abbildung: Die technische Kette führt von den autoritativen Test- und Modellbeschreibungen über Prompt-Generierung, Modell-Ausführung, Normalisierung und Bewertung zum geprüften Dashboard-Stand.
Der Ablauf der Kette umfasst folgende Stufen:
- Testfälle und Modellmetadaten werden in strukturierten Quellen gepflegt.
- Aus den Testfällen entstehen ausführbare Prompt-Artefakte.
- Aus den Modellmetadaten entsteht die Liste der einzubeziehenden Modellvarianten.
- Jede Modell-Testfall-Kombination wird mit der vorgesehenen Zahl von Wiederholungen ausgeführt.
- Jeder Run wird mit Antwort, Laufzeit und technischem Status protokolliert.
- Die Rohdaten werden in ein einheitliches Run-Format überführt.
- Technische Fehler werden von fachlich bewertbaren Antworten getrennt.
- Deterministische Regeln oder ein LLM-Judge bewerten die fachliche Qualität.
- Die Einzelwerte werden nach Modell, Testfall, Kategorie und Modell-Testfall-Kombination aggregiert.
- Ein geprüfter Build erzeugt das öffentliche LLM Testsuite Dashboard und optionale Exporte.
Autoritative Testdefinitionen
Jeder Testfall besitzt eine stabile ID und eine strukturierte Definition. Zu ihr gehören mindestens Aufgabenbeschreibung, Prompt, Kategorien und Bewertungsgrundlage. Abhängig vom Testtyp können Sollwert, zulässige Muster, Pflichtstrukturen, fachliche Judge-Kriterien oder Hinweise zur Normalisierung hinzukommen.
Die Testdefinition ist die methodische Quelle. Ein daraus erzeugter Prompt ist nur das Artefakt, das dem Modell übergeben wird. Fachliche Beschreibung, Kategorisierung und Bewertungsregeln bleiben getrennt erhalten. Dadurch kann später eindeutig geprüft werden, welcher Prompt-Stand zu einem Run gehörte und nach welcher Regel die Antwort bewertet wurde.
Prompt-Hashes dienen als Fingerabdruck. Wird ein Prompt verändert, entsteht ein anderer Hash-Wert. Ergebnisse verschiedener Prompt-Stände können damit getrennt werden, auch wenn der Testfallname gleich bleibt.
Modell-Inventar und Ausführungswege
Das Modell-Inventar erfasst Modellname, Familie, Variante, Anbieter oder Provider, Eingabeart, gegebenenfalls Kontextangaben und den Zugangsweg. Lokale Modelle, Cloud-Modelle und API-basierte Modelle werden nicht stillschweigend vermischt, sondern als unterschiedliche Zugangswege gekennzeichnet.
Die Kennzeichnung ist für die Interpretation notwendig. Laufzeit, Timeout-Verhalten und technische Verfügbarkeit hängen nicht nur vom Modell, sondern auch von Hardware, Netzwerk, Provider und Quantisierung ab. Das LLM Testsuite Dashboard kann deshalb nach Ausführungsweg filtern.
Erzeugung der Ausführungsartefakte
Aus der vollständigen Testdefinition wird ein Ausführungsartefakt erzeugt, das den eigentlichen Prompt enthält. Analog wird aus dem Modell-Inventar eine Liste der für einen Lauf vorgesehenen Modellvarianten gebildet.
Diese Ableitung verhindert doppelte Pflege. Änderungen erfolgen an der autoritativen Quelle und werden kontrolliert in die Ausführung übernommen. Der technische Prozess protokolliert, welche Test- und Modellstände verwendet wurden.
Durchführung der Modellläufe
Die Ausführung kombiniert Modelle und Testfälle systematisch. Für jede Kombination werden mehrere Wiederholungen gestartet. Die Zahl der Wiederholungen und das Zeitlimit werden für den jeweiligen Lauf dokumentiert.
Ein einzelner Run erfasst mindestens:
| Bereich | Typische Inhalte |
|---|---|
| Identifikation | Testfall, Modell, Run-Index, Zeitstempel |
| Ausführungsbedingungen | Ausführungsweg, Wiederholungszahl, Timeout |
| Technik | Rückgabestatus, Timeout-Kennzeichen, Abschlussgrund |
| Zeit | Start, Ende und Dauer |
| Inhalt | vollständige Antwort und gekürzte Vorschau |
| Provenienz | Prompt-Fingerabdruck und Versionsbezüge |
Tritt ein Timeout oder technischer Abbruch auf, wird dieser Zustand als Ergebnis gespeichert. Ein technischer Fehler wird nicht als fehlende Beobachtung verworfen. Er ist selbst ein relevanter Teil der Modellbewertung.
Rohdaten und Normalisierung
Provider und lokale Laufzeitumgebungen liefern unterschiedliche Antwortstrukturen. Die Normalisierung überführt diese heterogenen Rohdaten in ein gemeinsames Schema mit einer Zeile beziehungsweise einem Datensatz pro Run.
Dabei werden beispielsweise Modellname, Testfall-ID, Laufzeit, technischer Status, Antwortlänge, Prompt-Fingerabdruck und Antworttext vereinheitlicht. Konsolensteuerzeichen und andere technisch störende Zeichen werden entfernt. Volltext und kompakte Vorschau können getrennt geführt werden, damit Detail-Analyse und Dashboard-Darstellung unterschiedliche Anforderungen erfüllen.
Die Normalisierung ist eine methodisch wichtige Stufe. Erst sie erlaubt, lokale und externe Läufe mit denselben Aggregations- und Bewertungsverfahren zu verarbeiten.
Technische Klassifikation
Vor jeder fachlichen Bewertung wird der technische Zustand bestimmt. Typische Klassen sind:
| Technischer Zustand | Bedeutung |
|---|---|
| erfolgreich | eine verwertbare Antwort wurde geliefert |
| Timeout | innerhalb des festgelegten Zeitlimits lag keine vollständige Antwort vor |
| leere Antwort | technisch wurde ein Lauf beendet, aber kein nutzbarer Inhalt geliefert |
| API- oder Provider-Fehler | die externe oder lokale Schnittstelle meldete einen Fehler |
| abweichender Rückgabestatus | der Prozess endete nicht mit einem erwarteten Erfolgsstatus |
| sonstiger Abschlussgrund | ein provider-spezifischer Abbruchzustand wurde gemeldet |
Diese Klassifikation verhindert, dass technische Ausfälle als semantische Fehler missverstanden werden. Für einen effektiven Gesamt-Score können technische Fehler dennoch mit null eingehen, weil sie in einer produktiven Anwendung ebenfalls zu einem nicht nutzbaren Ergebnis führen.
Fachliche Bewertung
Technisch erfolgreiche Antworten werden anschließend fachlich bewertet. Die LLM Testsuite verwendet dafür zwei Hauptwege:
Deterministische Regeln kommen zum Einsatz, wenn ein Ergebnis eindeutig maschinell prüfbar ist. Dazu gehören exakte oder normalisierte Werte, Zahlen, definierte Muster, Pflichtstrukturen, XML-Wohlgeformtheit, Validierung oder andere formale Kriterien.
Der LLM-Judge wird eingesetzt, wenn mehrere fachlich akzeptable Formulierungen oder Strukturen möglich sind und eine rein deterministische Prüfung die Aufgabe nicht angemessen abbilden würde. Der Judge erhält Testbeschreibung, erwartete Inhalte, Bewertungskriterien und Modell-Antwort. Sein Urteil wird mit Label, Score, Begründung und Versionsangaben gespeichert.
Die beiden Wege sind keine konkurrierenden Verfahren. Sie bilden eine abgestufte Methodik, bei der so viel wie möglich deterministisch geprüft wird und semantische Bewertung dort hinzukommt, wo sie notwendig ist.
Aggregation und Kennzahlen
Nach der Einzelbewertung werden Runs zu mehreren Sichten zusammengeführt:
- pro Modell,
- pro Testfall,
- pro Modell-Testfall-Kombination,
- pro Kategorie,
- pro Zugangsweg,
- bei Bedarf pro Bewertungsverfahren.
Die Modell-Testfall-Kombination ist besonders aussagekräftig. Sie verbindet die Detailtiefe einzelner Runs mit einer kompakten Aussage über Erfolgsquote, technischen Status, Score und Laufzeit für eine konkrete Fähigkeit.
Neben Mittelwerten werden Anzahl der Runs, bewertete Runs, vollständig korrekte Ergebnisse, Timeouts, fehlende Regeln, Median und P95 betrachtet. Dadurch bleibt sichtbar, wie belastbar eine Kennzahl ist.
Erzeugung des Dashboards
Das LLM Testsuite Dashboard wird aus geprüften Aggregationen und Metadaten erzeugt. Die Ergebnisdaten werden so aufbereitet, dass Filter, Tabellen, Diagramme und Detail-Ansichten im Browser arbeiten können. Der veröffentlichte Stand benötigt für die reine Exploration keinen direkten Zugriff auf Modellprovider und startet keine neuen Modellläufe.
Diese Trennung vereinfacht Archivierung und Veröffentlichung. Ein Dashboard-Build kann als zusammengehöriger Stand mit Zeitstempel, Methodenfassung, Testkatalogversion und Prüfsummen dokumentiert werden.
Qualitätskontrolle vor der Veröffentlichung
Bevor ein Dashboard-Stand veröffentlicht wird, werden mindestens folgende Punkte geprüft:
- Stimmen Testfall-IDs, Modellnamen und Kategorien?
- Sind technische Fehler korrekt klassifiziert?
- Sind Bewertungsregeln und Judge-Versionen dokumentiert?
- Lassen sich Aggregationen auf Einzelruns zurückführen?
- Sind nicht freigegebene oder sensible Inhalte ausgeschlossen?
- Stimmen Dashboardwerte und maschinenlesbare Exporte überein?
- Sind Build-Datum und Methodenfassung angegeben?
Erst nach dieser Prüfung wird der Stand als öffentliches Ergebnisartefakt freigegeben.
Transparenz ohne Quellcodeveröffentlichung
Die Methodikstudie erklärt den gesamten Verfahrensweg, die verwendeten Datenobjekte, die Bewertungslogik, die Kennzahlen und die Qualitätssicherung. Damit kann die Methode fachlich beurteilt und veröffentlichte Resultate können sachgerecht interpretiert werden.
Nicht Bestandteil der öffentlichen Veröffentlichung sind:
- Quellcode und interne Skripte,
- konkrete Befehle und Automatisierungsdateien,
- Zugangsdaten und Provider-Konfigurationen,
- interne Netzwerk- und Infrastrukturangaben,
- nicht freigegebene Rohdaten und Caches,
- betriebliche Monitoring- und Sicherheitsinformationen.
Diese Grenze bedeutet nicht, dass der Prozess geheim bleibt. Sie trennt methodische Transparenz von der Herausgabe der konkreten Software-Implementierung.
Reproduzierbare Builds und Provenienz
Jeder veröffentlichte Build soll auf eindeutig versionierte Eingaben zurückführbar sein. Dazu gehören Testdefinitionen, Prompt-Fingerabdrücke, Modellbezeichnungen, Laufdaten, Bewertungsregeln, Judge-Konfigurationen, Aggregationen und Freigabestatus.
Die Provenienz einer Kennzahl beginnt beim Testfall und führt über den einzelnen Run und die angewandte Bewertungsregel bis zur Aggregation im LLM Testsuite Dashboard. Wird eine Regel korrigiert, kann nachvollzogen werden, welche Ergebnisse neu zu bewerten sind. Wird ein Prompt verändert, werden alte und neue Läufe getrennt behandelt.
Reproduzierbarkeit bedeutet in diesem Projekt, dass data2type einen veröffentlichten Stand intern aus seinen versionierten Artefakten erneut erzeugen und methodische Änderungen erklären kann. Eine öffentliche Freigabe des Quellcodes ist dafür keine Voraussetzung.
Wartbarkeit und Weiterentwicklung
Die Architektur ist stufenweise aufgebaut. Testdefinition, Ausführung, Normalisierung, technische Klassifikation, fachliche Bewertung, Aggregation und Veröffentlichung bleiben als eigene Verantwortungsbereiche erkennbar.
Diese Trennung erlaubt technische Modernisierungen, ohne das fachliche Datenmodell aufzugeben. Künftig können beispielsweise andere Speichertechnologien, zusätzliche Provider, neue Validatoren oder weitere Ausgabeformate ergänzt werden. Entscheidend ist, dass die Herkunft und Bedeutung der Ergebnisse stabil bleibt.