




6 Modelle, Zugangswege und Testdurchführung
Dieses Kapitel beschreibt, wie Large Language Models identifiziert, unter vergleichbaren Bedingungen ausgeführt und über mehrere Wiederholungen hinweg beobachtet werden. Es behandelt Modellmetadaten, Zugangswege, Timeouts, Kontextbedingungen, Providerunterschiede und faire Vergleichsgruppen.
Modell-Identität ist mehr als ein Name
Ein Vergleich ist nur dann nachvollziehbar, wenn das getestete Modell eindeutig beschrieben wird. Ein Familienname allein genügt nicht. Relevante Merkmale sind:
- getesteter Modellname und Tag,
- Modellfamilie,
- Größe und gegebenenfalls Quantisierung,
- Kontextfenster,
- unterstützte Eingabeart,
- Provider,
- Zugangsweg,
- Zeitpunkt des Tests,
- relevante Laufparameter.
Zwei Varianten derselben Familie können sich deutlich unterscheiden. Ebenso kann derselbe sichtbare Modellname bei einem externen Dienst aktualisiert werden. Die LLM Testsuite speichert deshalb Varianten- und Laufmetadaten getrennt von den Ergebniswerten.
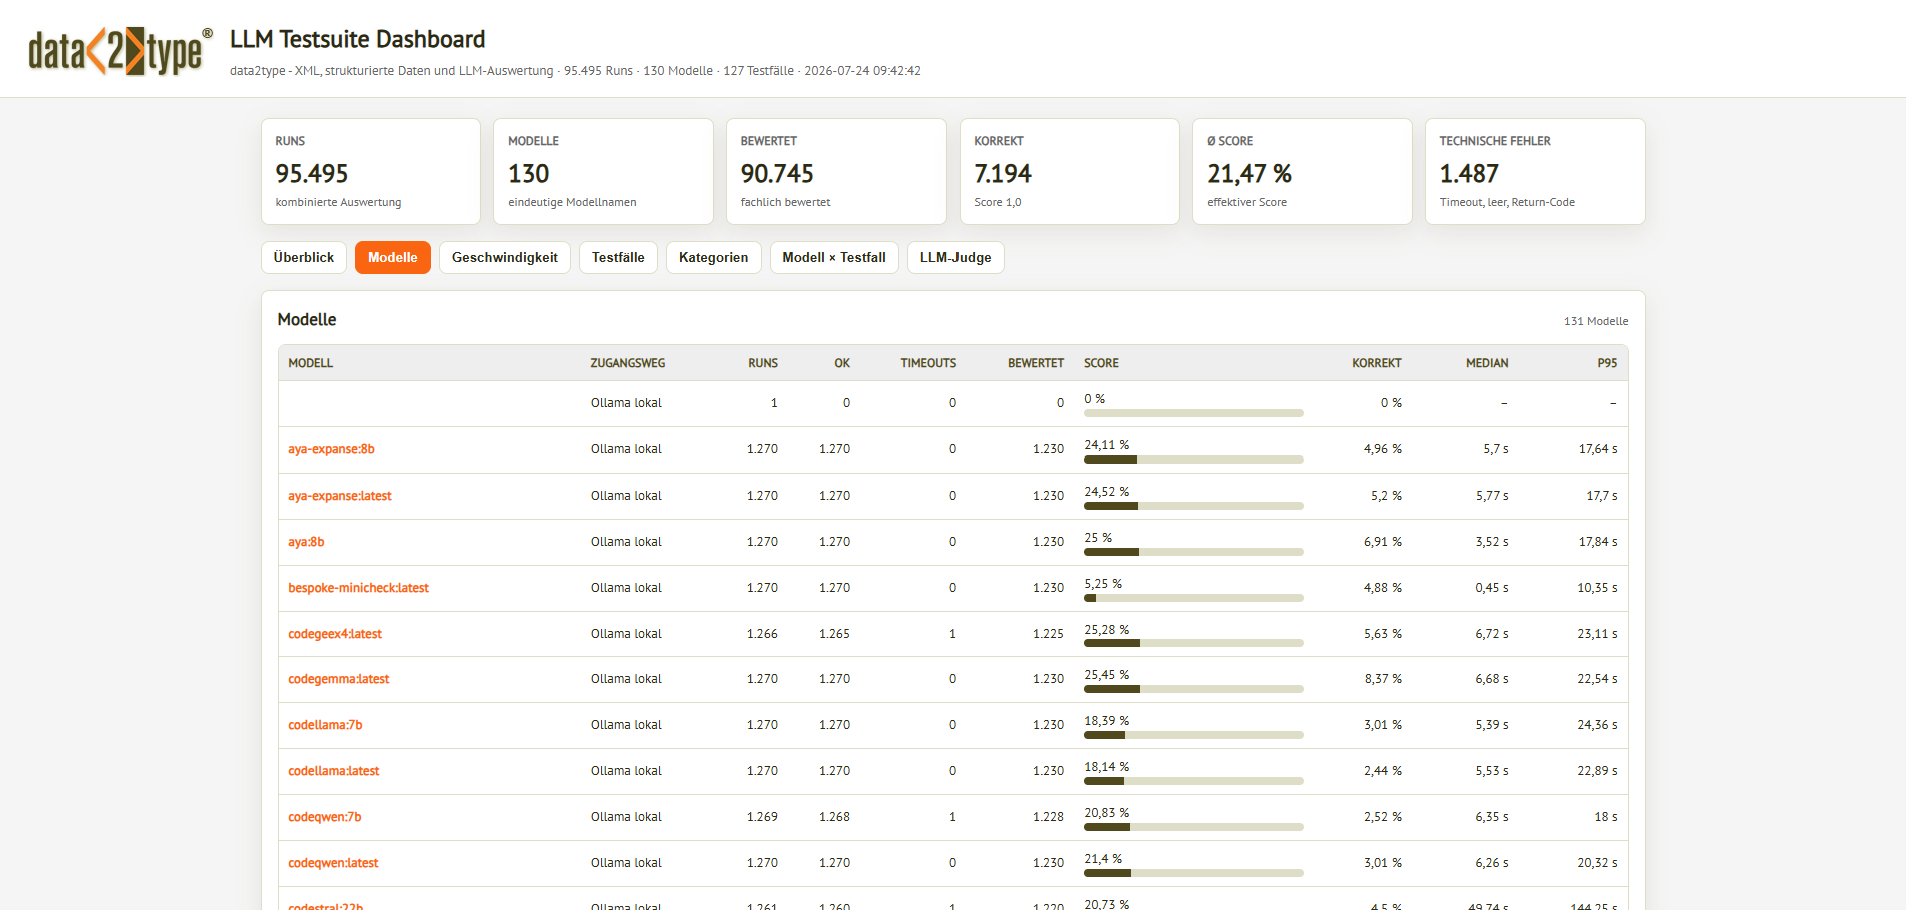
Abbildung: Die Modell-Ansicht stellt für jedes verwendete LLM den Zugangsweg, Anzahl der Runs, technische Erfolge, Timeouts, bewertete Läufe, Score, Korrekt-Rate sowie Laufzeitkennzahlen gegenüber.
Modellmetadaten
Die technische Modellquelle enthält Familien, Varianten, Größen, Kontextangaben, Eingabearten, Kurzbeschreibungen und Auszüge aus Modell-Informationen. Diese Metadaten dienen nicht als Qualitätsbeweis. Sie helfen, Testgrenzen und Ergebnisunterschiede einzuordnen.
Ein großes Kontextfenster bedeutet beispielsweise nicht automatisch, dass ein Modell lange strukturierte Dokumente korrekt interpretiert. Es zeigt zunächst nur, dass eine bestimmte Eingabelänge technisch vorgesehen ist. Die praktische Fähigkeit muss getestet werden.
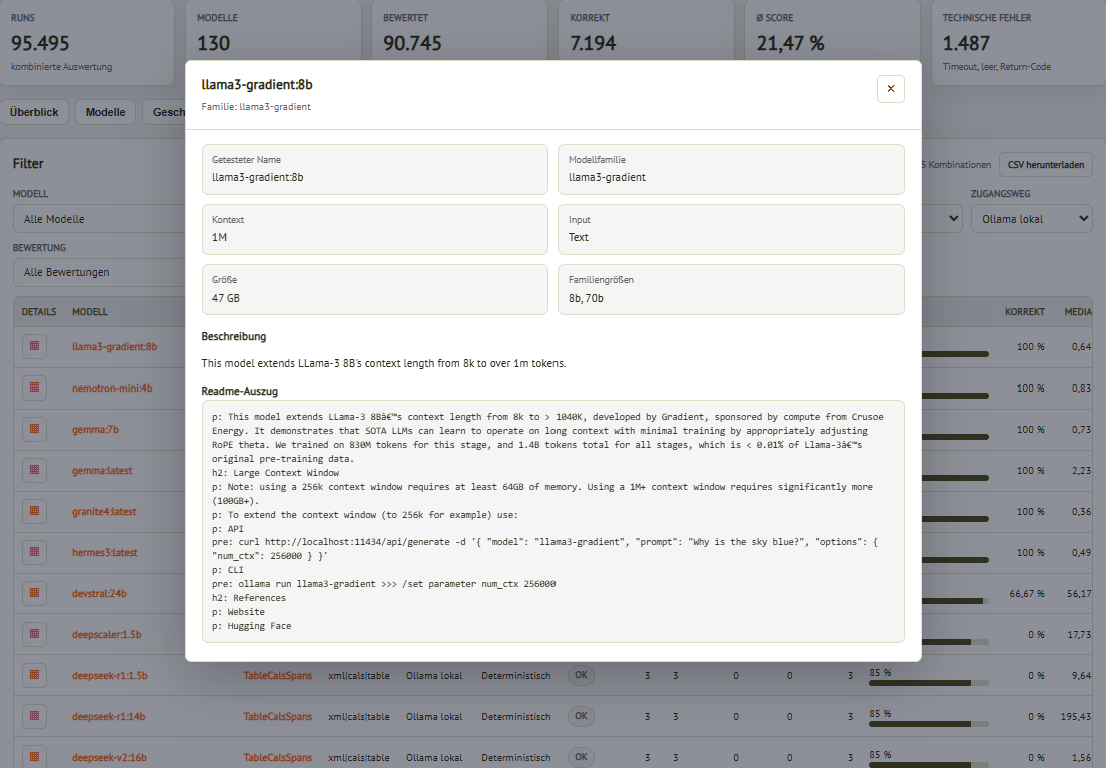
Abbildung: Die Detail-Ansicht eines Modells im LLM Testsuite Dashboard zeigt getesteten Namen, Familie, Kontext, Eingabeart, Größe, Familiengrößen, Beschreibung und einen Readme-Auszug. Solche Metadaten unterstützen die Interpretation, ersetzen aber keine Messung.
Zugangswege
Die LLM Testsuite unterscheidet Modell und Zugangsweg. Im aktuellen System treten insbesondere drei Wege auf:
| Zugangsweg | Charakteristik |
|---|---|
| Ollama lokal | Ausführung auf eigener Hardware, hohe Kontrolle über die Umgebung |
| Ollama Cloud | Externe Ausführung über einen cloud-basierten Modellzugang |
| OpenAI | API-basierte Ausführung über den jeweiligen Anbieterzugang |
Die Bezeichnung des Zugangsweges ist wichtig, weil Laufzeit, Verfügbarkeit, Limits, Modellstand und Fehlerprofile davon abhängen können.
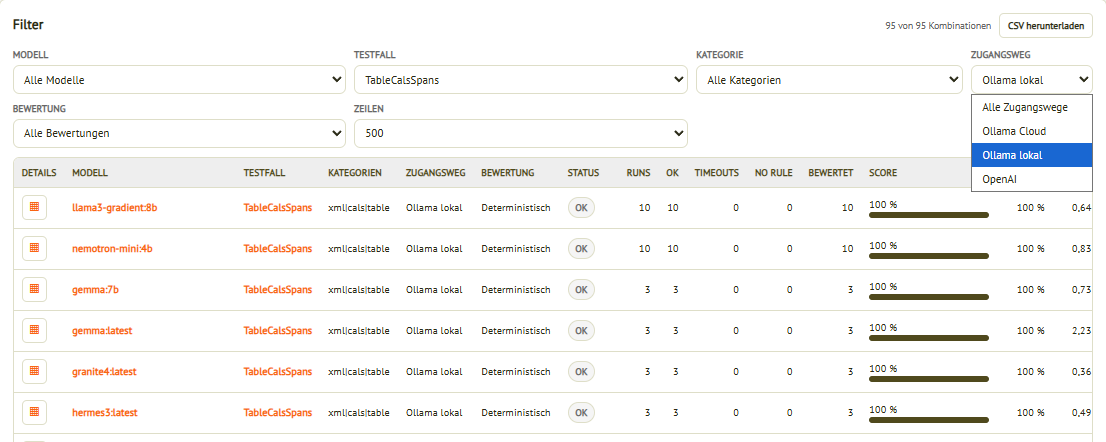
Abbildung: Die Modell-Testfall-Ansicht kann auf Ollama Cloud, Ollama lokal oder OpenAI eingegrenzt werden. Dadurch werden technische Betriebsmodelle getrennt analysierbar.
Lokale und externe Ausführung
Eine lokale Ausführung bietet Kontrolle über Hardware, Modellartefakte und Datenhaltung. Ergebnisse hängen dabei jedoch von CPU, GPU, Arbeitsspeicher, Quantisierung, Ollama-Version und Systemlast ab.
Externe Dienste reduzieren den lokalen Betriebsaufwand, führen aber weitere Einflussgrößen ein. Dazu gehören Netzwerklatenz, Rate Limits, serverseitige Modell-Updates und nicht vollständig sichtbare Inferenzkonfigurationen.
Aus diesem Grund ist ein Laufzeitvergleich über Zugangswege hinweg nur als Systemvergleich zu verstehen. Er misst die beobachtete End-to-End-Dauer und nicht ausschließlich die Rechengeschwindigkeit des Modellkerns.
Generierung identischer Prompt-Artefakte
Die autoritativen Testdefinitionen liegen in XML vor. Aus ihnen werden Prompt-Dateien generiert. Der Dateiname transportiert die Testfall-ID, der Datei-Inhalt den reinen Prompt-Text. Dieses Verfahren stellt sicher, dass alle Modelle innerhalb eines Prompt-Stands dieselbe Aufgabenbeschreibung erhalten.
Der Prompt-Hash wird zusätzlich in Katalog und Run-Daten gespeichert. So kann erkannt werden, ob scheinbar gleich benannte Tests tatsächlich dieselbe Prompt-Fassung verwenden.
Wiederholungen
Die lokale Ausführung unterstützt eine konfigurierbare Anzahl von Wiederholungen und ein festgelegtes Zeitlimit pro Run. In einem dokumentierten Lauf wurden beispielsweise zehn Iterationen und ein Timeout von 1.200 Sekunden verwendet. In den Ergebnisdaten können je nach Testphase, Modell und Ausführungsweg auch andere Anzahlen auftreten.
Vergleiche müssen deshalb die reale Zahl der Runs ausweisen. Eine Korrektrate von 100 Prozent bei drei Runs besitzt eine andere statistische Stabilität als dieselbe Rate bei zehn oder hundert Runs.
Timeout und Abbruchverhalten
Ein Timeout wird pro Wiederholung erfasst. In der dokumentierten lokalen Ausführung wird der betroffene Run gespeichert. Die verbleibenden Wiederholungen für diesen Testfall können anschließend abgebrochen werden, bevor die Verarbeitung mit dem nächsten Testfall fortgesetzt wird.
Dieses Verhalten schützt lange Testserien vor einem dauerhaften Blockieren. Es führt zugleich dazu, dass Modell-Testfall-Kombinationen unterschiedlich viele Runs besitzen können. Die Aggregation muss diese Differenz sichtbar lassen.
Einheitliche Bedingungen und ihre Grenzen
Innerhalb eines Ausführungswegs sollten Prompt, Systemanweisung, Temperatur, Timeout, Iterationszahl und weitere Parameter möglichst konstant sein. Vollständige Gleichheit ist über verschiedene Anbieter und lokale Systeme jedoch nicht immer erreichbar.
Die Methodik verlangt deshalb keine vorgetäuschte Homogenität. Stattdessen werden Bedingungen dokumentiert und Vergleiche entsprechend eingeschränkt. Für eine spezifische Forschungsfrage kann ein balancierter Teildatensatz gebildet werden, der nur Modelle mit identischer Testabdeckung und vergleichbaren Einstellungen enthält.
Modell-Updates und Wiederholung
Modelle und APIs verändern sich ständig. Eine wiederholte Ausführung derselben Tests zu einem späteren Zeitpunkt kann deshalb andere Ergebnisse liefern. Das ist kein Fehler der LLM Testsuite, sondern ein relevanter Untersuchungsgegenstand.
Für Langzeitvergleiche sollten Modellstand, Testdatum, Prompt-Hash und Bewertungsregel gemeinsam eingefroren werden. So lassen sich Fortschritt, Rückschritt oder verändertes Betriebsverhalten nachvollziehen.
Parameter und Antwortbedingungen
Ein Modellname allein reicht für die Reproduktion eines Laufs nicht aus. Soweit verfügbar, werden deshalb auch Kontextlänge, Temperatur, Antwortlimit, Systemanweisungen, Timeout und API-Modus dokumentiert. Bei lokalen Modellen kommen Quantisierung, Runtime und Hardware hinzu.
Nicht jeder Provider erlaubt dieselbe Kontrolle. Manche Parameter werden serverseitig festgelegt oder nur indirekt beeinflusst. Solche Unterschiede werden nicht durch scheinbare Gleichheit verdeckt, sondern als Teil des Ausführungswegs dokumentiert.
Kontextfenster und Prompt-Größe
Die Testfälle reichen von kurzen Aufgaben bis zu sehr großen strukturierten Dokumenten. Ein Modell kann eine Aufgabe fachlich beherrschen und dennoch an einer zu großen Eingabe scheitern. Deshalb werden Prompt-Länge und, soweit verfügbar, Token-Zahlen erfasst.
Bei einem Vergleich großer Office- oder XML-Serialisierungen ist zu prüfen, ob alle Modelle die vollständige Eingabe erhalten haben. Abschneiden, serverseitige Kürzung oder unterschiedliche Tokenisierung können sonst als fachlicher Fehler erscheinen. Testfälle, die das Kontextfenster bewusst untersuchen, müssen von unbeabsichtigten Überläufen getrennt werden.
Provider-bedingte Unterschiede
Cloud-Anbieter können Moderation, Rate Limits, Warteschlangen, automatische Wiederholungen oder Modell-Routing einsetzen. Lokale Umgebungen sind stärker von Hardware, Speicher und Runtime abhängig. Beide Gruppen besitzen daher eigene technische Fehlerprofile.
Das LLM Testsuite Dashboard weist den Zugangsweg (Ollam Cloud, Ollama lokal oder OpenAI) aus, damit fachliche und operative Unterschiede getrennt betrachtet werden können. Ein direkter Geschwindigkeitsvergleich ist nur sinnvoll, wenn Startpunkt, gemessene Dauer und Parallelisierung vergleichbar sind.
Ressourcen und Kosten
Neben der reinen Antwortzeit können Rechenbedarf, Speicherverbrauch und API-Kosten für die Modell-Auswahl relevant sein. Diese Werte sind nicht in jedem Datenstand vollständig vorhanden, können aber künftig als zusätzliche operative Dimension ergänzt werden.
Eine sehr hohe fachliche Qualität kann für seltene Spezialaufgaben wirtschaftlich sein, während ein schnelleres, kleineres Modell für große Mengen einfacher Extraktionen geeigneter ist. Die LLM Testsuite soll solche Abwägungen ermöglichen, ohne fachlichen Score und Betriebskosten zu einer undurchsichtigen Kennzahl zu vermischen.
Faire Vergleichsgruppen
Für belastbare Aussagen werden Modelle bevorzugt innerhalb sinnvoller Vergleichsgruppen betrachtet. Dazu können gleiche Providerwege, ähnliche Größenklassen, identische Testabdeckung oder dieselbe Modellfamilie gehören. Ein globaler Vergleich bleibt möglich, muss aber die unterschiedlichen Bedingungen offenlegen.
Research Notes sollen deshalb genau benennen, welche Modelle in die Analyse aufgenommen wurden und warum. Eine Auswahl nach auffälligem Ergebnis allein kann zu verzerrten Aussagen führen.