




8 Statistik, Reproduzierbarkeit und Performance
Dieses Kapitel erklärt die statistischen Kennzahlen der LLM Testsuite und ihre Interpretation. Im Mittelpunkt stehen Scores, Wiederholbarkeit, Laufzeitkennzahlen, Unsicherheit, Stichprobengrößen und die Frage, unter welchen Bedingungen Performance-Vergleiche sinnvoll sind.
Kennzahlen brauchen einen klaren Nenner
Die LLM Testsuite aggregiert einzelne Runs. Jede Kennzahl muss erkennen lassen, auf welche Menge sie sich bezieht. Besonders wichtig sind die Unterschiede zwischen allen Runs, technisch erfolgreichen Runs und fachlich bewerteten Runs.
| Kennzahl | Bedeutung |
|---|---|
| Runs | Anzahl der gespeicherten Wiederholungen |
| OK | technisch erfolgreiche Runs |
| Timeouts | Runs mit überschrittenem Zeitlimit |
| No Rule | technisch erfolgreiche Runs ohne Bewertungsregel |
| Bewertet | fachlich bewertete Runs |
| Correctness Score | fachlicher Score, technische Fehler ausgenommen |
| Effektiver Score | Score einschließlich technischer Fehler als 0 |
| Korrekt | Anteil vollständig korrekter bewerteter Runs |
| Median | mittlere beobachtete Laufzeit technisch erfolgreicher Runs |
| P95 | Laufzeit, unter der 95 Prozent der technisch erfolgreichen Runs liegen |
Die Bezeichnung „Score“ allein ist ohne diese Definitionen zu ungenau.
Effektiver Score
Der effektive Score verbindet fachliche Qualität und technische Verfügbarkeit. Ein Timeout oder eine leere Antwort ist für einen Produktionsprozess kein nutzbares Ergebnis und wird deshalb mit 0 berücksichtigt.
Der fachliche Correctness Score beantwortet dagegen die Frage, wie gut technisch verwertbare Antworten sind. Beide Werte sind nützlich, beantworten aber unterschiedliche Fragen.
Reproduzierbarkeit
Ein Modell ist für Automatisierung besonders geeignet, wenn es eine Aufgabe wiederholt korrekt löst. Deshalb sollte eine Modell-Testfall-Kombination nicht nur über den Mittelwert beschrieben werden.
Zusätzliche Perspektiven sind:
- Anzahl der Wiederholungen,
- Anteil technisch erfolgreicher Runs,
- Anteil vollständig korrekter Runs,
- Verteilung der Teilbewertungen,
- häufigste Fehlertypen,
- Streuung der Laufzeiten,
- Wechsel zwischen korrekten und falschen Ausgabeformen.
Ein Modell, das in zehn Läufen fünfmal korrekt und fünfmal falsch antwortet, hat eine andere Risikostruktur als ein Modell mit zehn konsistent partiellen Antworten, selbst wenn ein Mittelwert ähnlich ausfällt.
Median und P95
Der Median ist robust gegenüber einzelnen sehr langen Läufen. Er beschreibt den typischen Wert besser als ein arithmetischer Mittelwert, wenn Laufzeiten schief verteilt sind.
P95 zeigt die lange Seite der Verteilung. Für interaktive Systeme oder zeitkritische Pipelines ist P95 oft wichtiger als der Median, weil Nutzer und nachgelagerte Prozesse gerade die langsamen Fälle wahrnehmen.
Beide Kennzahlen werden nur für technisch erfolgreiche Runs berechnet. Timeouts werden separat gezählt und dürfen nicht aus der operativen Interpretation verschwinden.
Score und Laufzeit
Ein schnelleres Modell ist nicht automatisch fachlich besser. Umgekehrt garantiert eine lange Laufzeit keinen hohen Score. Das folgende Streudiagramm macht sichtbar, ob Modelle in einem bestimmten Datenstand günstige Kombinationen aus Qualität und Geschwindigkeit erreichen.
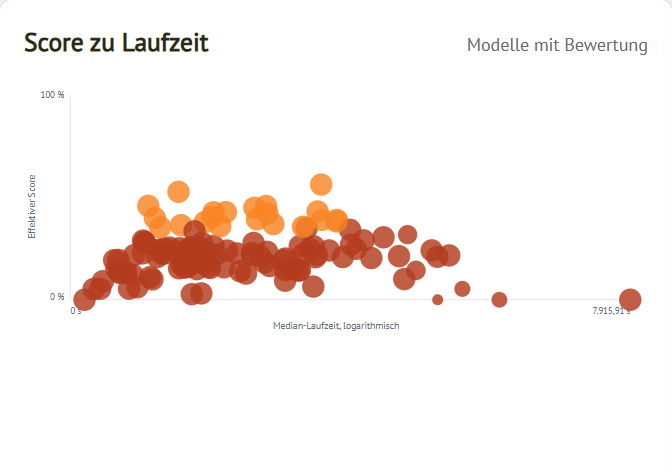
Abbildung: Die Median-Laufzeitachse ist logarithmisch. Jeder Punkt steht für ein LLM mit Bewertung. Die Grafik dient zur Exploration eines konkreten Datenstands und belegt keinen allgemeinen Kausalzusammenhang zwischen Laufzeit und Qualität.
Performance nach Ausführungsweg
Die Geschwindigkeits-Ansicht im LLM Testsuite Dashboard gruppiert Modelle nach Zugangsweg. Dadurch lassen sich lokale und externe Systeme getrennt betrachten.
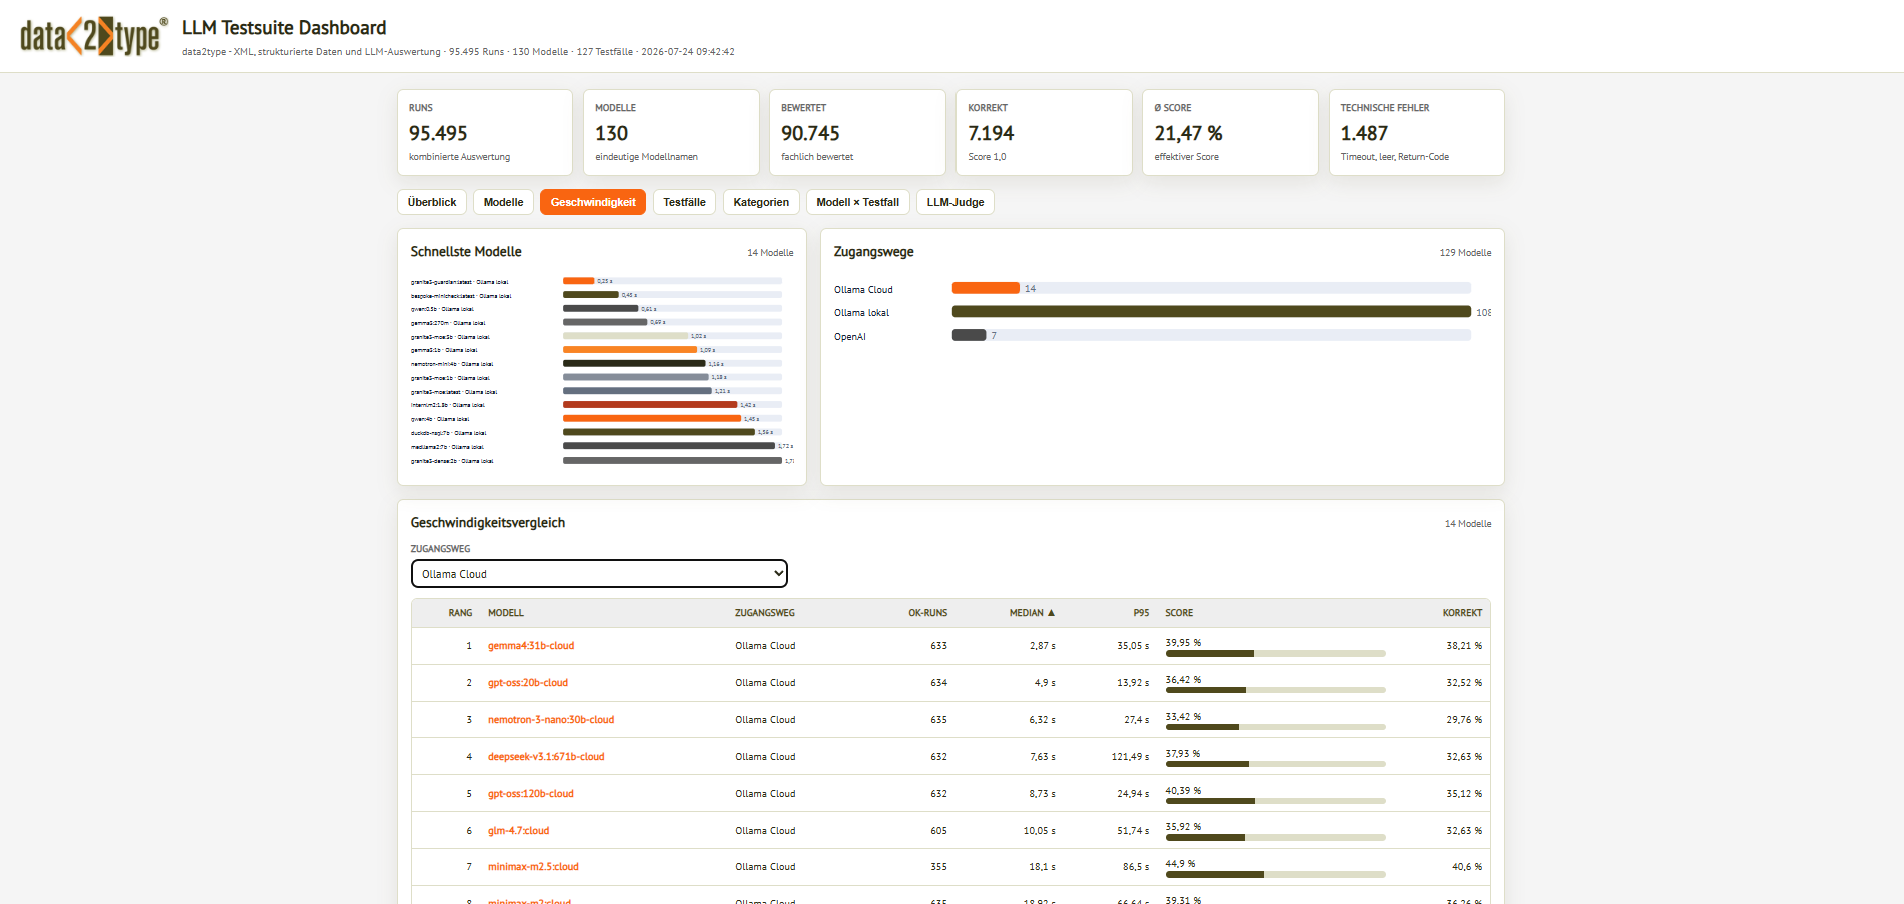
Abbildung: Die Ansicht zeigt die schnellsten Modelle, die Verteilung der Zugangswege und einen tabellarischen Vergleich mit u.a. Median, P95, Score und Korrektrate.
Ein Vergleich über Zugangswege hinweg muss Hardware, Netzwerk und Provider-Bedingungen berücksichtigen. Die gemessene Dauer ist eine End-to-End-Kennzahl der konkreten Umgebung.
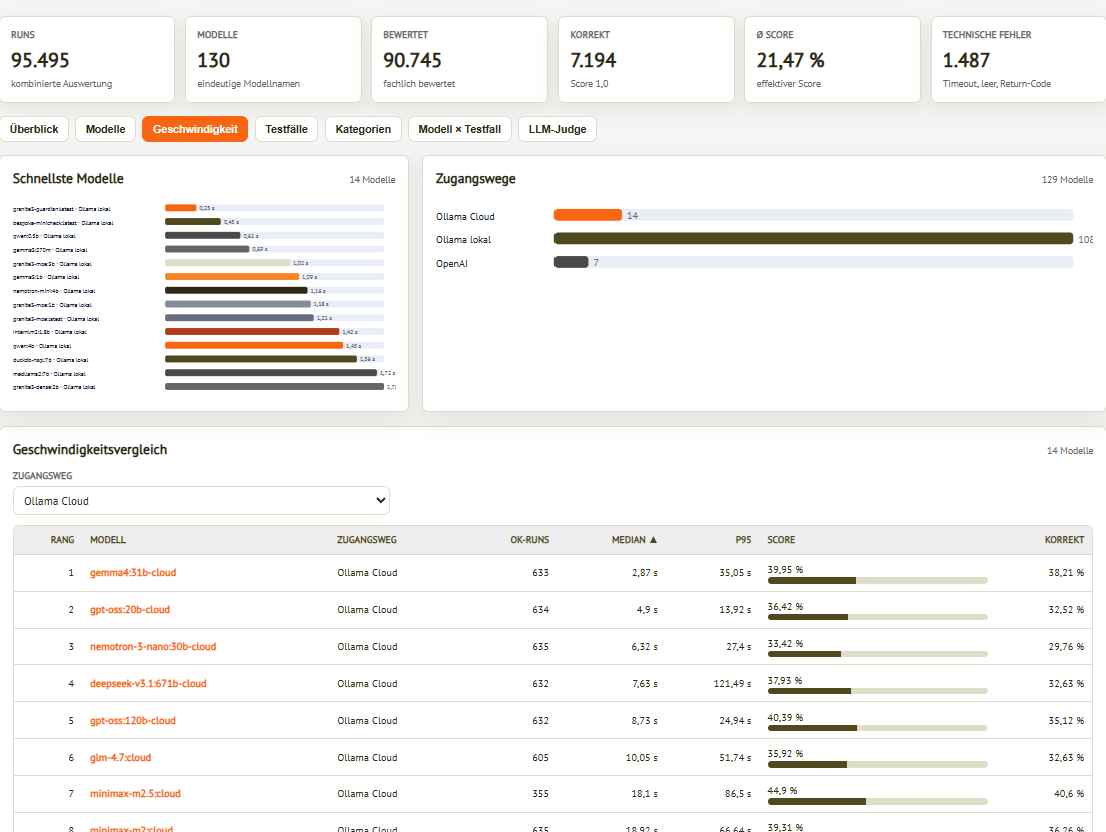
Abbildung: Die Tabelle kombiniert operative und fachliche Kennzahlen. Eine Modellwahl sollte nicht allein nach der Rangfolge des Medians erfolgen, sondern Qualität, P95, Abdeckung und Betriebsanforderungen einbeziehen.
Drilldown auf einzelne Wiederholungen
Aggregationen müssen bis zur Roh-Beobachtung zurückverfolgbar sein. Die Detail-Ansicht einer Modell-Testfall-Kombination zeigt Runs, Status, Label, Score, Dauer, Rückgabe-Code, Antwortlänge und Ausgabevorschau.
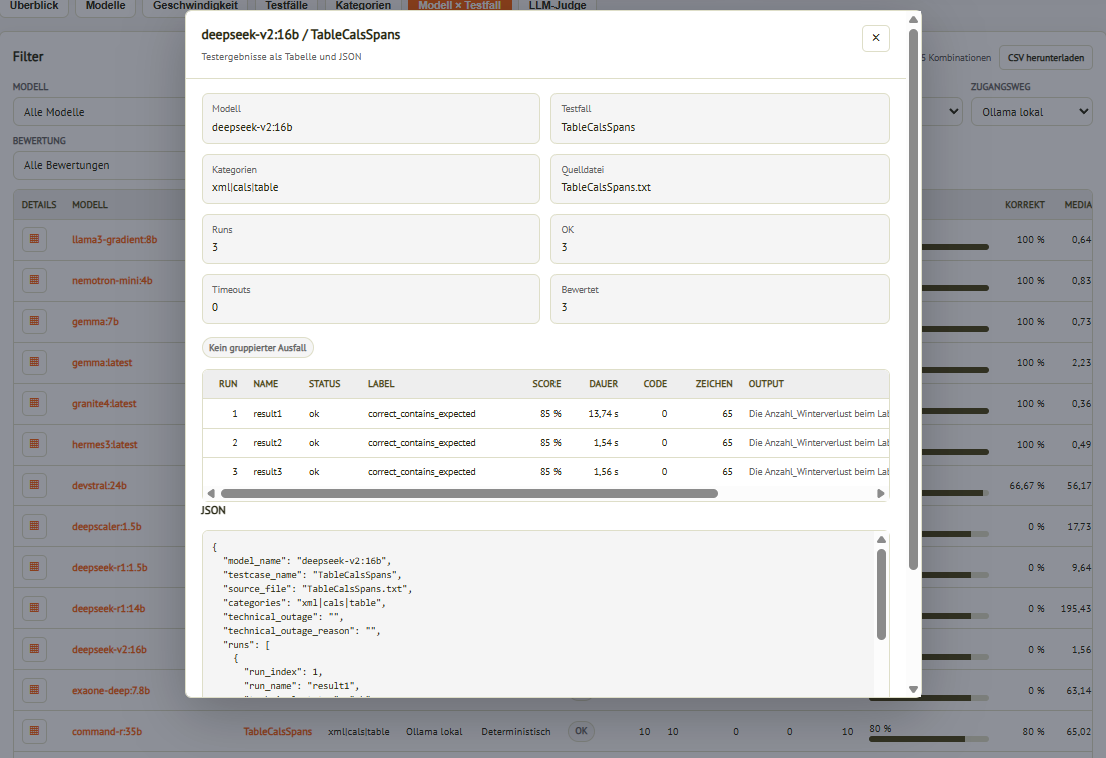
Abbildung: Die Detail-Ansicht verbindet Aggregation und Einzelläufe. Sie zeigt drei technisch erfolgreiche Runs, ihre Labels und Laufzeiten sowie einen JSON-Auszug für die weitere Prüfung.
Ungleiche Abdeckung
Nicht jedes Modell hat notwendigerweise jeden Testfall in derselben Anzahl absolviert. Gründe können Timeouts, spätere Aufnahme, Kontextgrenzen, Provider-Limits oder laufende Erweiterung sein.
Globale Modellvergleiche sollten deshalb mindestens folgende Bedingungen prüfen:
- identische oder ausreichend überlappende Testmenge,
- vergleichbare Anzahl bewerteter Runs,
- gleiche Bewertungsregeln,
- dokumentierte Ausführungswege,
- Umgang mit fehlenden Kombinationen.
Eine sinnvolle Ergänzung sind balancierte Ranglisten, die nur eine gemeinsame Testmenge verwenden.
Weiterführende statistische Verfahren
Für Research Notes können über die Dashboard-Kennzahlen hinaus weitere Verfahren eingesetzt werden:
- Konfidenzintervalle für Erfolgsquoten,
- Bootstrap-Intervalle für Score-Unterschiede,
- gepaarte Tests bei identischen Aufgabenvarianten,
- Effektgrößen statt alleiniger Rangfolgen,
- Varianzanalysen nach Format, Modellfamilie und Ausführungsweg,
- Stabilitätsmaße über Wiederholungen,
- Sensitivitätsanalysen für unterschiedliche Score-Gewichte.
Diese Verfahren sollten themenspezifisch eingesetzt werden. Das Live-Dashboard bleibt bewusst verständlich und explorativ.
Unsicherheit und Stichprobengröße
Eine Erfolgsquote von 80 Prozent besitzt bei fünf Läufen eine andere Aussagekraft als bei fünfzig Läufen. Deshalb müssen Quote und Anzahl der zugrunde liegenden Beobachtungen gemeinsam betrachtet werden. Kleine Stichproben können einen ersten Hinweis liefern, sollten aber nicht mit hoher Genauigkeit interpretiert werden.
Für ausgewählte Research Notes können Konfidenzintervalle, Bootstrapverfahren oder Sensitivitätsanalysen ergänzt werden. Die öffentliche Standardansicht bleibt bewusst verständlich, soll aber die zugrunde liegende Anzahl der Runs jederzeit zeigen.
Gewichtung von Testfällen
Ein ungewichteter Gesamt-Score behandelt jeden bewerteten Run gleich. Das ist transparent, aber nicht für jeden Anwendungsfall passend. Eine Organisation kann komplexe Standard-Erzeugung höher gewichten als einfache Zahlenausgabe oder umgekehrt.
Die Methodik trennt deshalb den veröffentlichten Standard-Scope von anwendungsspezifischen Gewichtungen. Das LLM Testsuite Dashboard kann Teilmengen filtern. Individuelle Gewichtungen sollten als eigene Auswertung gekennzeichnet werden und dürfen nicht stillschweigend als allgemeiner Testsuite-Score erscheinen.
Zeitreihen und Modell-Updates
Bei wiederholten Builds können Kennzahlen über die Zeit verglichen werden. Dafür müssen Testdefinition, Regelversion und Modell-Identität stabil oder zumindest dokumentiert sein. Ein Modellname, der vom Anbieter intern aktualisiert wird, kann eine scheinbare Zeitreihe erzeugen, obwohl sich das zugrunde liegende System verändert hat.
Zeitreihen werden daher bevorzugt auf eindeutig versionierten Modellvarianten aufgebaut. Wo das nicht möglich ist, wird der Zeitpunkt der Messung als Teil der Modell-Identität betrachtet.
Grenzen von Performancevergleichen
Laufzeiten hängen nicht nur vom Modell ab. Prompt-Größe, Antwortlänge, HardwareAuslastung, Netzwerk, Provider-Warteschlange, Cold Start und Parallelisierung können die Messung verändern. Median und P95 beschreiben den beobachteten Betrieb im jeweiligen Setup, nicht eine unveränderliche Eigenschaft des Modells.
Performance-Beiträge sollen deshalb die Messumgebung und die betrachtete Aufgabenmenge nennen. Ein Modell kann bei kurzen Extraktionen schnell und bei langen Generierungsaufgaben langsam sein. Kategoriale Laufzeitprofile sind häufig aussagekräftiger als ein einziger Gesamtwert.
Stabilität als eigenständige Qualitätsdimension
Ein Modell mit durchschnittlich gutem Score, aber starken Schwankungen kann für unbeaufsichtigte Automatisierung ungeeignet sein. Umgekehrt kann ein etwas niedrigerer, aber sehr stabiler Score für einen kontrollierten Prozess wertvoller sein.
Künftige Auswertungen können deshalb neben Mittelwert und Quote zusätzliche Stabilitätskennzahlen verwenden, etwa Varianz, Anteil vollständig konsistenter Modell-Testfall-Kombinationen oder die Wahrscheinlichkeit mindestens eines Fehlers in einer Folge mehrerer Produktionsläufe.