
Fallstudie: NCBI Bookshelf / JATS-nahe Daten
Die Demonstrationsdaten basieren auf dem öffentlichen NCBI-Bookshelf-Titel Advances in Patient Safety: From Research to Implementation. Die lokale Datei aps_NBK20452.jats.ocf wird als realistisches Beispielpaket verwendet. Sie enthält ein großes XML-Dokument, viele Medien-Assets, Metadaten und Validierungsreports.
Das historische Ausgangsmodell ist relevant. NCBI dokumentiert das Book Tag Set als DTD-basiertes Vokabular für Lehrbücher und Monografien. Das Book Tag Set wurde aus der NLM/JATS-Modulfamilie aufgebaut und für NCBI-Bookshelf-Inhalte verwendet. Version 3.0 der Book-DTD wurde am 21. November 2008 veröffentlicht; NCBI stellt die DTD als book3.dtd bereit. Außerdem dokumentiert NCBI Bookshelf-Harvesting-Formate und heutige Einreichungsanforderungen, inklusive der Präferenz für BITS in modernen Workflows.
Genau diese Situation begegnet einem in realen Migrationen. Das Archiv ist kein zufälliges XML. Es wurde gegen ein dokumentiertes, öffentliches Modell erstellt. Das zukünftige Produktionssystem sollte die vollständige alte DTD trotzdem nicht blind übernehmen. Der breite Standard ist ein nützlicher Referenzpunkt; der neue Produktionsprozess benötigt ein kontrolliertes Subset.
In diesem Beispiel ist das Ziel ein JATS-artiges Subschema für Publikationen. Das bedeutet: Wir bleiben an einem bekannten Standardvokabular ausgerichtet, verwenden intern aber ein kleineres Regelwerk. Wir verwenden also einfach nicht alle Elemente und Strukturen, die der Standard erlauben würde. Das ist in XML-Projekten normal, weil niemand alles umsetzt, was theoretisch erlaubt sein könnte. Zum Glück. Das Ziel-Subset sagt: Diese JATS-Strukturen wollen wir tatsächlich, diese Werte akzeptieren wir, und diese Normalisierungen verlangen wir sowohl für Manuskripte als auch für die Migration von Bestandswerken.
Schritt 1: Alte DTD finden, aber dort nicht stehen bleiben
Der erste technische Schritt besteht darin, die alte DTD zu finden und zu dokumentieren. Für NCBI Bookshelf ist die relevante öffentliche DTD-Familie das NCBI Book Tag Set. In einem anderen Projekt kann es eine lokale Redaktions-DTD, ein DocBook-Customizing, eine DITA-Spezialisierung, ein TEI-Customizing oder ein proprietäres Inhaltsmodell sein.
Die DTD zu dokumentieren, gibt dem Projekt eine Basis. Sie zeigt, welchem Vokabular die Dateien folgen sollten, welche Module verfügbar waren, welche Elementnamen im alten Umfeld Bedeutung hatten und auf welche Constraints sich die bisherigen Redakteure verlassen konnten. Das ist wichtig für Nachvollziehbarkeit, besonders wenn Tausende Titel migriert werden müssen und die Migration auch Jahre später erklärbar bleiben soll.
Die alte DTD ist jedoch nur die Obergrenze der alten Welt. Sie sagt, was vorkommen konnte, nicht was tatsächlich vorkommt. In einer großen Bibliothek nutzt der Großteil der Dateien nur ein Subset der DTD. Manche optionalen Strukturen erscheinen nie. Manche Elemente kommen nur in alten Projekten vor. Manche Attribute sind technisch erlaubt, werden aber semantisch uneinheitlich verwendet. Manche Werte sind projektspezifische Konventionen, die nie formalisiert wurden. Deshalb reicht die DTD nicht aus, um das neue XSD zu entwerfen.
Das Migrationsteam sollte die alte DTD als Dokumentation bewahren und als Referenz verwenden. Das neue Schema sollte jedoch aus dem realen Korpus abgeleitet und für den Zielprozess kuratiert werden.
Schritt 2: Korpus mit XQuery oder BaseX analysieren
Bevor das Ziel-XSD entworfen wird, sollte der Korpus in eine XML-Datenbank wie BaseX geladen werden. So lassen sich Fragen über Tausende Dateien hinweg stellen. Das Ziel ist nicht nur, Elemente zu zählen. Das Ziel ist, Modellierungsmuster, Legacy-Ausnahmen und Qualitätsrisiken zu entdecken.
Nützliche Analysefragen sind zum Beispiel:
- Welche Elemente kommen überhaupt vor, und wie häufig?
- Welche Elemente kommen nur in wenigen Legacy-Titeln vor?
- Welche Attribute haben unkontrollierte Wertebereiche?
- Wie sind Datumsangaben codiert?
- Wie sind Maßeinheiten codiert: 10cm, 10 cm, 10 cm, 10 centimeters?
- Sind Bildpfade relativ, absolut, gemischt, doppelt oder kaputt?
- Welche Processing Instructions existieren, und welche sind veraltet?
- Sind Abkürzungen, Satzzeichen und mikrotypografische Konventionen konsistent?
Die Demo-Abfrage liegt in beispiele/xquery/corpus-analysis.xq. Ein repräsentativer Ausschnitt sieht so aus:
xquery version "3.1";

declare namespace xlink = "http://www.w3.org/1999/xlink";

let $docs := collection("legacy-jats")
return
  <analysis>
    <element-inventory>{
      for $name in distinct-values($docs//* ! node-name(.))
      order by string($name)
      return <element name="{$name}" count="{count($docs//*[node-name(.) = $name])}"/>
    }</element-inventory>
    <unit-spacing>{
      for $hit in $docs//text()[matches(., '\d+(cm|mm|kg|%)')]
      return <hit source="{base-uri($hit)}">{normalize-space($hit)}</hit>
    }</unit-spacing>
  </analysis>
Dieser Schritt verändert die Diskussion. Statt abstrakt über eine große DTD zu sprechen, arbeitet das Team mit Evidenz: "Nur diese Abschnittstypen kommen vor", "Diese Datumsformen müssen normalisiert werden", "Diese Bildreferenzen sind uneinheitlich", "Diese PIs sind veraltet", "Diese Maßeinheiten brauchen redaktionelle Regeln".
Schritt 3: Beobachtetes Schema mit Trang ableiten
Der nächste Schritt besteht darin, aus den realen XML-Dateien ein erstes maschinell erzeugtes Schema zu bauen. Das James-Clark-Tool für diesen Schritt ist Trang. Trang ist ein Schema-Konverter für XML. Er kann zwischen RELAX NG, DTD und W3C XML Schema konvertieren und außerdem aus einem oder mehreren XML-Beispieldokumenten ein Schema ableiten.
In einem Migrationsprojekt ist Trang nützlich, weil es ein beobachtetes Schema liefert. Das ist nicht das endgültige Schemamodell. Es ist eine technische Zusammenfassung dessen, was die aktuellen Dokumente benötigen, wenn alle beobachteten Strukturen valide bleiben sollen.
trang -I xml -O xsd legacy-samples/*.xml generated/observed-from-data.xsdFür eine Migration von DTD nach XSD kann Trang auch verwendet werden, um eine DTD als Vergleichspunkt nach XSD zu konvertieren:
trang -I dtd -O xsd old-model/book3.dtd generated/from-old-dtd.xsdBeide Ergebnisse sind nützlich, sollten aber nicht unkritisch übernommen werden. Das DTD-abgeleitete XSD kann zu breit sein, weil es das gesamte alte Vokabular widerspiegelt. Das XML-abgeleitete XSD kann zu eng oder zu zufällig sein, weil es nur das Sample-Set widerspiegelt. Das Migrationsteam vergleicht beides und entwirft danach ein kuratiertes Schema.
Beispielkapitel: Aus XML-Daten mit Trang zum XSD
Das XHTML-Übungsmaterial zeigt den praktischen Workflow in kompakter Form. Es beginnt mit einer echten XML-Instanz und erzeugt daraus ein erstes Schema. Dieses erste Schema ist nützlich, weil es zeigt, wie die Daten aussehen. Es braucht aber menschliche Schemaarbeit, bevor daraus ein wartbares Produktionsmodell wird.
Die lokalen Beispieldateien liegen in beispiele/trang-xhtml/:
- XHTML-BeispielDokument.xhtml: die XML-Beispieldaten.
- 01-observed-from-data.xsd: das erste Schema, das die beobachteten Daten widerspiegelt.
- 02-curated-xhtml-subset.xsd: das manuell verbesserte Schema.
1. Mit einer XML-Instanz beginnen
Das XHTML-Beispiel ist bewusst dokumentzentriert. Es enthält ein Wurzelelement, Metadaten in head, Inhalt in body, Überschriften, Listen, Absätze, Inline-Markup und eine Tabelle. Ein gekürzter Ausschnitt sieht so aus:
<html xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
      xsi:schemaLocation="http://www.w3.org/1999/xhtml http://www.w3.org/MarkUp/SCHEMA/xhtml11.xsd"
      xmlns="http://www.w3.org/1999/xhtml">
  <head>
    <title>Titel</title>
  </head>
  <body>
    <h1 id="id1" style="color:red">
      <a href=""/>
      <b><i><sub/></i></b>
      <br/>
    </h1>
    <ul><li/></ul>
    <p id="id2"><a href=""/><b><i><sub/></i></b><br/></p>
  </body>
</html>
In einer großen Migration wäre das nicht nur eine Datei. Es wäre ein repräsentatives Set von Dateien aus dem Archiv. Je besser das Sample-Set ist, desto nützlicher wird das beobachtete Schema.
2. Trang das erste XSD ableiten lassen
Trang kann direkt aus XML-Beispielen ein XSD ableiten. Für die XHTML-Übung lautet der Befehl:
trang -I xml -O xsd XHTML-BeispielDokument.xhtml 01-observed-from-data.xsdBei mehreren Beispieldateien werden alle Eingabe-XML-Dateien vor der Ausgabedatei angegeben:
trang -I xml -O xsd samples/*.xml generated/observed-from-data.xsdDas Ergebnis liegt bewusst nah am Beispiel. Das beobachtete Schema kann zum Beispiel festhalten, dass body genau die Sequenz enthält, die im Sample gefunden wurde:
<xs:element name="body">
  <xs:complexType>
    <xs:sequence>
      <xs:element ref="xhtml:h1"/>
      <xs:element ref="xhtml:h2"/>
      <xs:element ref="xhtml:h3"/>
      <xs:element ref="xhtml:h4"/>
      <xs:element ref="xhtml:h5"/>
      <xs:element ref="xhtml:h6"/>
      <xs:element ref="xhtml:ul"/>
      <xs:element ref="xhtml:ol"/>
      <xs:element ref="xhtml:p"/>
      <xs:element ref="xhtml:table"/>
    </xs:sequence>
  </xs:complexType>
</xs:element>
Für das Beispiel ist das korrekt, als Produktionsmodell aber zu eng. Es beschreibt eine konkrete Dokumentform, nicht das beabsichtigte Inhaltsmodell. Deshalb ist das generierte Schema der Startpunkt, nicht das Endergebnis.
3. Generiertes Schema prüfen
Die erste Prüfung fragt, welche Teile echte Regeln sind und welche nur Artefakte des Beispiels. In der XHTML-Übung zeigt das initiale Schema typische Probleme roher Ableitung:
- Es hält eine feste Reihenfolge von Überschriften und Blöcken fest, weil das Sample diese Reihenfolge benutzt.
- Es behandelt manche Werte als schwache Typen wie xs:NCName oder xs:NMTOKEN, weil die Sample-Werte zufällig diesen lexikalischen Formen entsprechen.
- Es wiederholt ähnliche Inline-Modelle, statt eine wiederverwendbare Gruppe zu benennen.
- Es macht manche Attribute verpflichtend, weil sie im Sample vorkamen, obwohl das zukünftige Modell eine andere Regel benötigen kann.
Dieser Review-Schritt ist der Beginn der Schemaarbeit. Das Team entscheidet, welche Constraints redaktionelle Absicht ausdrücken und welche nur zufällig aus dem Sample stammen.
4. Schema in wiederverwendbare Gruppen überführen
Die kuratierte XHTML-Lösung führt Gruppen für wiederkehrende Inhaltsklassen ein. Genau dieser Designschritt ist auch in einer Publikationsmigration erforderlich: Überschriften, Blockelemente und Inline-Elemente werden zu benannten Strukturen, die konsistent wiederverwendet werden können.
<xs:group name="Titel">
  <xs:choice>
    <xs:element ref="h1"/>
    <xs:element ref="h2"/>
    <xs:element ref="h3"/>
    <xs:element ref="h4"/>
    <xs:element ref="h5"/>
    <xs:element ref="h6"/>
  </xs:choice>
</xs:group>

<xs:group name="inzeilig">
  <xs:choice>
    <xs:element ref="a"/>
    <xs:element ref="b"/>
    <xs:element ref="br"/>
    <xs:element ref="i"/>
    <xs:element ref="sub"/>
  </xs:choice>
</xs:group>
Das Body-Modell kann dann auf semantische Gruppen verweisen, statt jedes konkrete Element in einer festen beobachteten Reihenfolge aufzulisten:
<xs:element name="body">
  <xs:complexType>
    <xs:sequence>
      <xs:group ref="Titel"/>
      <xs:group ref="Block"/>
      <xs:element ref="table"/>
    </xs:sequence>
  </xs:complexType>
</xs:element>
5. Datentypen verbessern
Das Schema-Seminar-Material betont einen der Hauptgründe für den Wechsel von DTD zu XSD: Datentypen und Wertebereiche. DTDs können keinen String von einem Dezimalwert, einem Datum oder einem kontrollierten Sprachcode unterscheiden. XSD kann das.
In der XHTML-Übung werden Bezeichner von lexikalischen stringartigen Typen zu echten XML-IDs verbessert:
<xs:attribute name="id" use="required" type="xs:ID"/>Für Publikationsdaten wird dasselbe Prinzip auf Datumsangaben, Prozentwerte, Statuswerte, Sprachcodes, ISBNs, Währungen, Dateireferenzen und kontrollierte redaktionelle Kategorien angewendet. Hier wird Migration zur Qualitätsverbesserung und bleibt keine mechanische Konvertierung.
6. Schema dokumentieren
Das Seminar-Material führt außerdem xs:annotation und xs:documentation ein. Das kuratierte XHTML-Schema nutzt dieses Muster, um das Schema für Menschen lesbar und für generierte Dokumentation nutzbar zu machen:
<xs:annotation>
  <xs:documentation>XHTML exercise schema</xs:documentation>
</xs:annotation>
In einem Migrationsprojekt gehört Dokumentation direkt ins Schema, wenn sie Modellierungsentscheidungen erklärt: warum ein Subset existiert, warum ein Wertebereich gewählt wurde, welches Legacy-Muster normalisiert wurde und welcher Manuskript-Workflow von einem Typ abhängt.
7. Validieren, überarbeiten und wiederholen
Der letzte Schritt ist iterativ. Die Beispieldateien werden gegen das kuratierte Schema validiert. Wenn Dateien fehlschlagen, wird der Grund klassifiziert: Das XML muss möglicherweise migriert werden, das Schema ist vielleicht zu streng, oder der Korpus enthält eine Legacy-Ausnahme, die eine explizite Projektentscheidung erfordert. Diese Feedbackschleife ist dieselbe Schleife, die im Migrationsmuster gezeigt wird: Befunde verfeinern Subset und Transformation.
Schritt 4: Ziel-XSD kuratieren
Das kuratierte XSD ist das eigentliche Migrationsziel. Hier werden Projektentscheidungen ausführbar. Das XSD sollte kleiner sein als die alte DTD, wo das alte Modell zu breit war, strenger sein, wo Legacy-Daten uneindeutig waren, und explizit sein, wo alte Konventionen nur implizit existierten.
Das Übungsmaterial zu XML Schema unterstützt genau diesen Modellierungsprozess: mit Struktur beginnen, benannte Typen einführen, einfache Typrestriktionen ergänzen, Enumerationen und Patterns verwenden und informelle Konventionen in maschinenprüfbare Constraints überführen. In der JATS-Fallstudie ist das lokale Zielschema beispiele/schema/d2t-jats-subset.xsd.
Eine typische Verbesserung ist die Normalisierung von Datumsangaben. Das Legacy-XML verwendet getrennte Elemente:
<pub-date>
  <day>30</day>
  <month>07</month>
  <year>2026</year>
</pub-date>
Das kuratierte Zielschema kann ein echtes ISO-Datum verlangen:
<xs:simpleType name="iso-date">
  <xs:restriction base="xs:date"/>
</xs:simpleType>
Eine weitere Verbesserung ist die Normalisierung von Einheiten. Legacy-Daten können Breiten in Pixeln, Zentimetern, Prozent oder freiem Text enthalten. Das Ziel-Subset kann verlangen, dass nur Prozentwerte verwendet werden:
<xs:simpleType name="percentage">
  <xs:restriction base="xs:decimal">
    <xs:minInclusive value="0"/>
    <xs:maxInclusive value="100"/>
  </xs:restriction>
</xs:simpleType>
Auch Abschnittstypen können kontrolliert werden. Statt beliebige Legacy-Labels wie Heading1, Heading2 oder lokale Stilnamen zu akzeptieren, definiert das Zielmodell ein kleines redaktionelles Vokabular:
<xs:simpleType name="controlled-sec-type">
  <xs:restriction base="xs:token">
    <xs:enumeration value="frontmatter"/>
    <xs:enumeration value="chapter"/>
    <xs:enumeration value="section"/>
    <xs:enumeration value="references"/>
  </xs:restriction>
</xs:simpleType>
Genau darin liegt der Wert der Migration. Das Ergebnis ist nicht nur "altes XML in neuer Syntax". Das Ergebnis ist ein saubereres, kleineres, besser typisiertes und vorhersehbareres Produktionsmodell.
Schritt 5: Altes XML mit XSLT transformieren
Nachdem das Ziel-XSD kuratiert wurde, sind die Legacy-Dateien häufig nicht mehr dagegen valide. Das ist erwartet. Das Schema beschreibt den Zielzustand; XSLT beschreibt, wie man dorthin gelangt.
Das Stylesheet beispiele/xslt/legacy-jats-to-d2t-subset.xsl zeigt typische Migrationsregeln. Publikationsdaten werden in ISO-Form gebracht:
<xsl:template match="pub-date">
  <pub-date>
    <iso-date>
      <xsl:value-of select="format-number(number(year), '0000') || '-' ||
                            format-number(number(month), '00') || '-' ||
                            format-number(number(day), '00')"/>
    </iso-date>
  </pub-date>
</xsl:template>
Legacy-Abschnittsinformationen werden in kontrollierte Abschnittstypen überführt:
<xsl:template match="sec">
  <sec>
    <xsl:copy-of select="@id"/>
    <xsl:attribute name="sec-type">
      <xsl:choose>
        <xsl:when test="lower-case(@specific-use) = 'heading1'">chapter</xsl:when>
        <xsl:when test="lower-case(@specific-use) = 'ref'">references</xsl:when>
        <xsl:otherwise>section</xsl:otherwise>
      </xsl:choose>
    </xsl:attribute>
    <xsl:apply-templates/>
  </sec>
</xsl:template>
Bildreferenzen werden normalisiert, damit paketinterne Pfade vorhersehbar sind:
Für ein großes Archiv wird dieses Stylesheet zu einer Bibliothek von Migrationsentscheidungen. Jedes Template sollte nachvollziehbar sein: Welche alte Struktur behandelt es, welche neue Struktur erzeugt es, und welche Validierungsregel bestätigt das Ergebnis?
Schritt 6: Migration mit XProc orchestrieren
XSLT transformiert XML. Eine vollständige Migrationspipeline hat mehr Aufgaben. Sie muss Eingabedateien auswählen, Transformationen ausführen, Assets kopieren oder umbenennen, XML-Links umschreiben, ein Manifest aufbauen, Validatoren ausführen, Reports sammeln und ein Paket erzeugen. Das ist Orchestrierungsarbeit, und XProc ist dafür eine natürliche Technologie.
Eine vereinfachte XProc-Pipeline kann so aussehen:
<p:declare-step name="migrate-title" version="3.0"
                xmlns:p="http://www.w3.org/ns/xproc">
  <p:input port="source" primary="true"/>
  <p:output port="result" primary="true"/>

  <p:xslt name="lift-to-subset">
    <p:with-input port="stylesheet" href="xslt/legacy-jats-to-d2t-subset.xsl"/>
  </p:xslt>

  <p:store href="package/content/aps_NBK20452.xml"/>
  <p:archive format="zip" href="output/aps_NBK20452.d2t-subset.ocf"/>
</p:declare-step>
In der Produktion hätte XProc zusätzliche Schritte für Bildnormalisierung, Dateinamenregeln, Link-Umschreibung, Manifest-Erzeugung, XSD-Validierung, Schematron-Validierung, Linkprüfung und Dashboard-Export. Wichtig ist: Die Pipeline migriert eine Publikation, nicht nur eine XML-Datei.
Was OCF ist und warum es wichtig ist
OCF steht für Octopus Container Format. In praktischen Publishing-Workflows ist ein OCF-Paket ein ZIP-basierter Container, der alle Dateien einer Publikation zusammenhält. Das genaue Profil kann je nach Projekt variieren, aber das Prinzip bleibt stabil: XML-Dokument, Bilder, Metadaten und Verarbeitungsreports liegen nicht in beliebigen Verzeichnissen verstreut. Sie werden als eine inspizierbare, übertragbare und validierbare Einheit paketiert.
Im Demonstrationspaket enthält das OCF:
- manifest.xml: das Inventar der Dateien im Paket.
- content/aps_NBK20452.xml: die Publikations-XML.
- content/images/: PDFs und JPEGs, die von der Publikation referenziert werden.
- meta/: Paketmetadaten.
- processing/validation/: Validierungsreports wie SVRL, Linkchecker-Ausgaben und Zusammenfassungen.
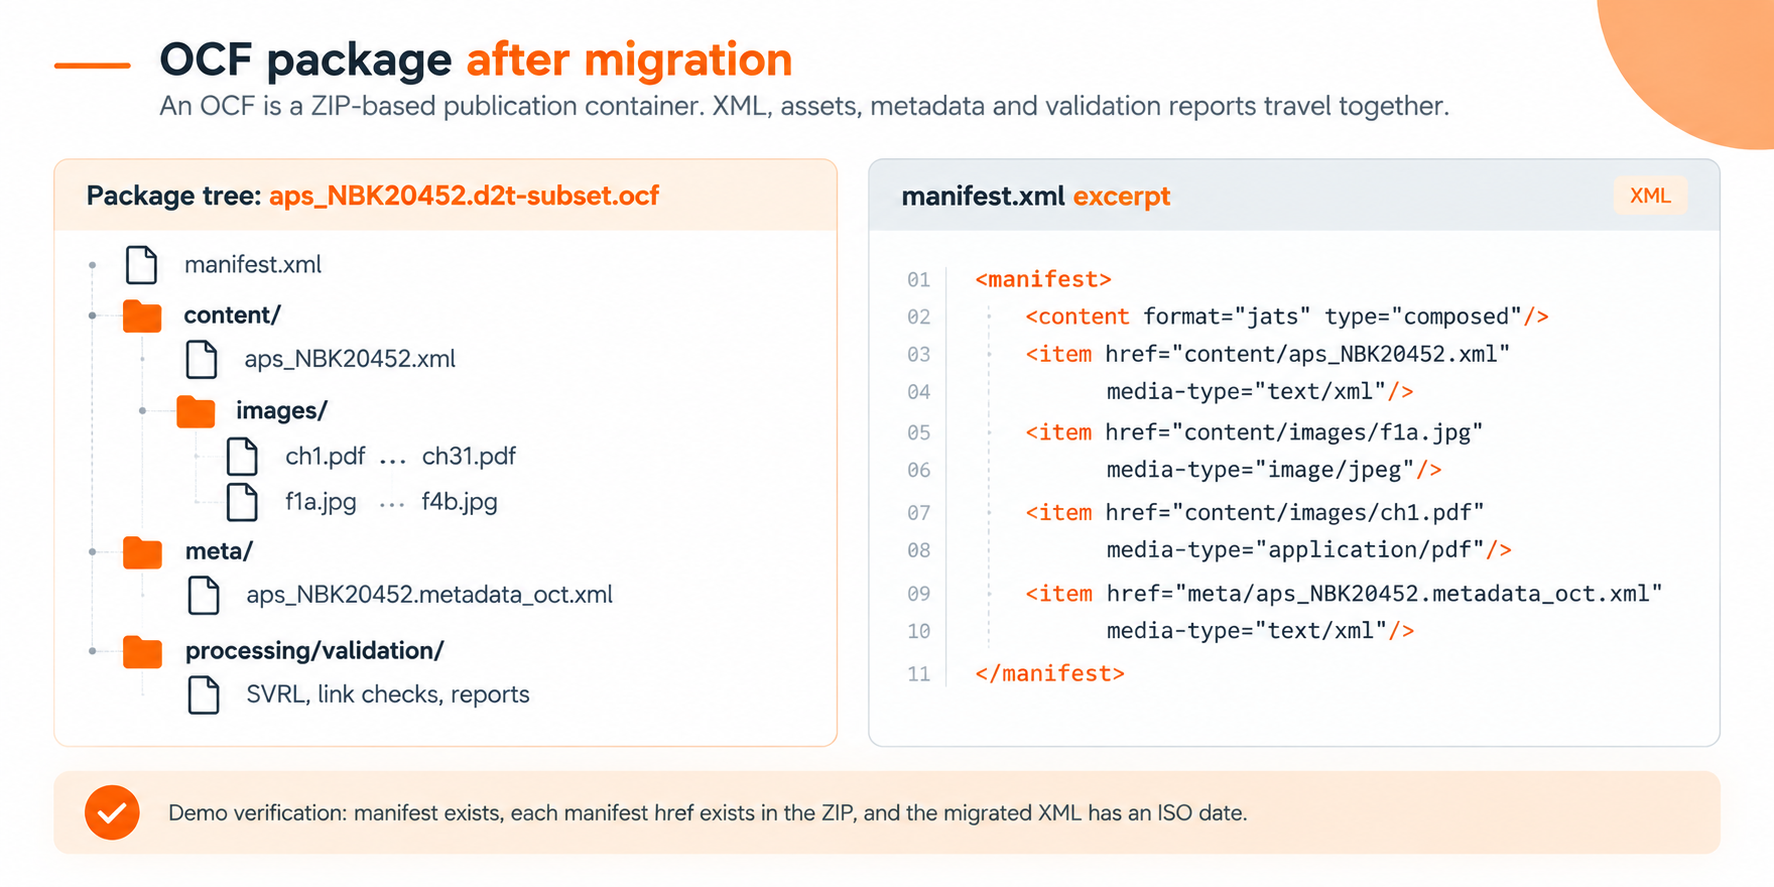
Das Manifest ist wesentlich, weil es das Paket maschinell prüfbar macht. Eine Pipeline kann prüfen, ob jede gelistete Datei existiert. Ein Linkchecker kann XML-Referenzen mit dem Paketinhalt vergleichen. Ein Dashboard kann anzeigen, welcher Titel welche Validierungsreports besitzt. Ein nachgelagertes Rendering-System findet die Content-Datei und die Assets, ohne Pfade raten zu müssen.
Das ist besonders wichtig in Migrationen, weil Legacy-Bilder oft an uneinheitlichen Orten liegen. Manche Dateien referenzieren ../images/f1a.jpg, andere graphics/f1a.jpg, wieder andere nur f1a.jpg. Eine Migrationspipeline kann sowohl den physischen Speicherort als auch die XML-Referenzen normalisieren. Nach der Migration ist die Regel einfach: Publikationsbilder liegen in content/images/, und XML-Referenzen zeigen dorthin.
Ausführbare Demo: OCF-Paket bauen
Die Demo enthält ein ausführbares Skript unter beispiele/scripts/build_ocf.py. Es führt eine kleine, aber vollständige Paketmigration aus:
- Das bereitgestellte Legacy-OCF lesen.
- Das Legacy-XML aus content/aps_NBK20452.xml laden.
- Publikationsdaten nach iso-date normalisieren.
- Legacy-Abschnittsstile auf kontrollierte sec-type-Werte mappen.
- Grafikreferenzen auf images/... normalisieren.
- Alle Medien-Assets in das neue Paketverzeichnis kopieren.
- Ein neues Manifest erzeugen.
- Ein neues ZIP-/OCF-Paket erstellen.
- Prüfen, ob jeder Manifest-Eintrag existiert und ob das migrierte XML ein normalisiertes Datum enthält.
Der lokale Test wurde mit folgendem Befehl ausgeführt:
python beispiele/scripts/build_ocf.py \
  --source-ocf aps_NBK20452.jats.ocf \
  --source-xml beispiele/input/content/aps_NBK20452.xml \
  --out-dir beispiele/output
Das getestete Ergebnis war:
created beispiele/output/aps_NBK20452.d2t-subset.ocf
copied_assets=63
Das erzeugte Ausgabepaket liegt unter beispiele/output/aps_NBK20452.d2t-subset.ocf. Das zur Inspektion entpackte Paket liegt unter beispiele/output/package/.
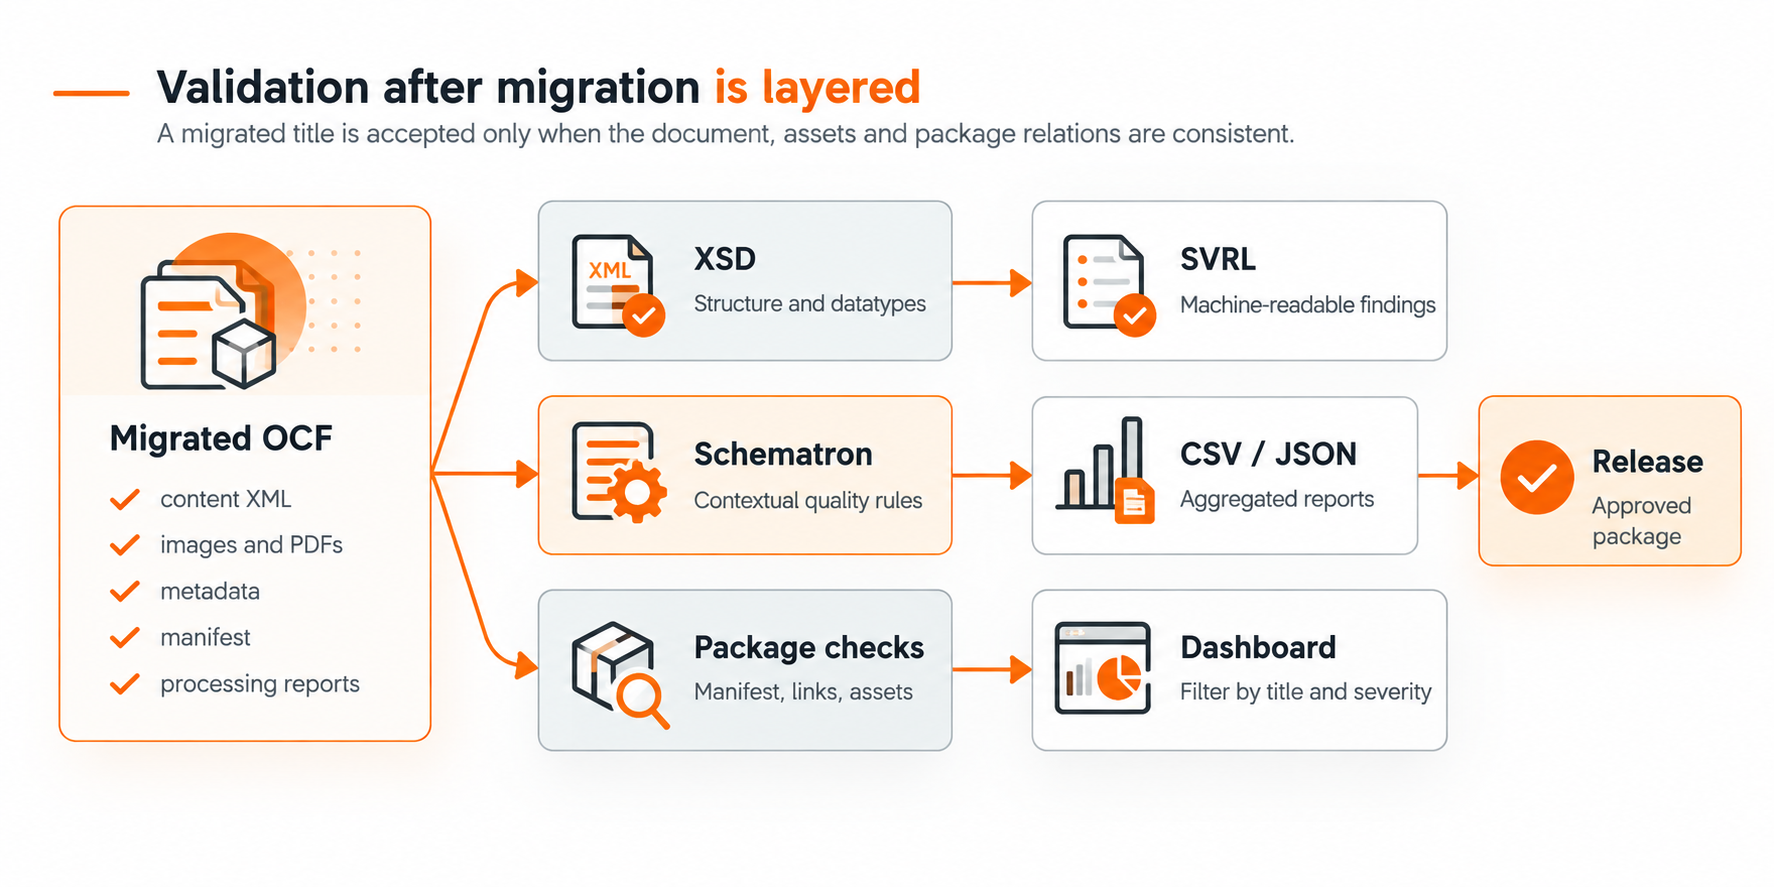
Schritt 7: Schematron für Migrationsqualität ergänzen
XSD validiert die Zielstruktur. Schematron validiert Migrationsqualität und redaktionelle Regeln. Die Demo-Datei beispiele/schematron/d2t-jats-quality.sch prüft Regeln wie normalisierte Paketbildpfade und Prozentbereiche:
<sch:rule context="graphic">
  <sch:assert test="starts-with(@xlink:href, 'images/')">
    Graphic references must point into the normalized images directory.
  </sch:assert>
  <sch:assert test="not(@width-percent) or (@width-percent ge 0 and @width-percent le 100)">
    Percent widths must be between 0 and 100.
  </sch:assert>
</sch:rule>
Schematron-Regeln entstehen oft direkt aus der Korpusanalyse. Wenn BaseX-Abfragen zeigen, dass Leerzeichen zwischen Zahl und Einheit uneinheitlich sind, wird ein Schematron-Report ergänzt. Wenn bestimmte Processing Instructions ungültig sind, wird eine Schematron-Regel ergänzt. Wenn Abkürzungen im Bestand variieren, entsteht eine kontrollierte Prüfung oder eine Reporting-Regel. Die Migration wird iterativ: Analyse findet Muster, XSLT behebt, was automatisch behoben werden kann, Schematron meldet, was geprüft werden muss.