



Wie funktioniert der QBK XML Differ?
Ein präziser Vergleich komplexer XML-Dokumente erfordert mehr als einen einfachen Textvergleich. Der QBK XML Differ versucht zunächst zu bestimmen, welche Bestandteile zweier Dokumentversionen zusammengehören. Erst auf dieser Grundlage wird ermittelt, was hinzugefügt, gelöscht, verändert oder verschoben wurde.
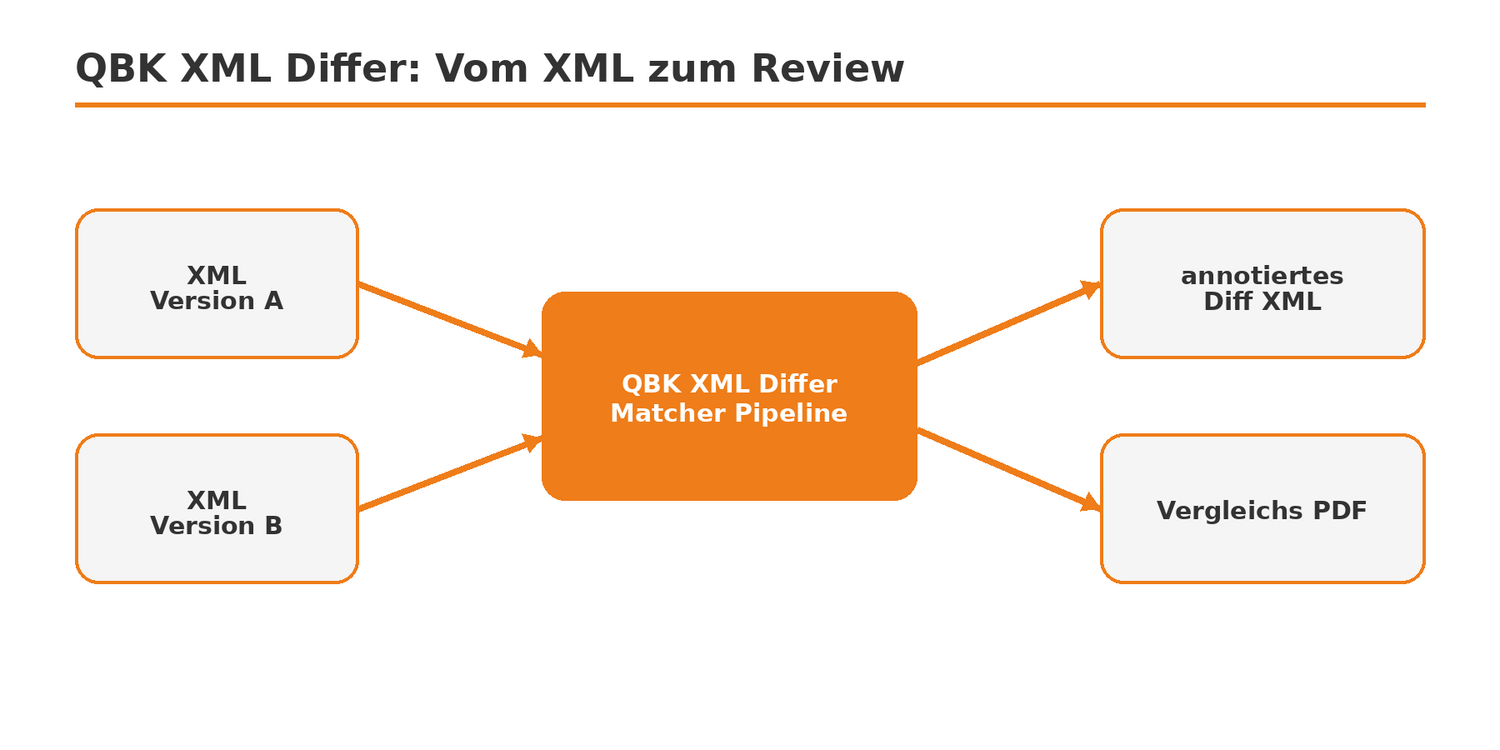
1. Zwei XML-Dokumentstände
Ausgangspunkt sind zwei XML-Dateien. Neben dem sichtbaren Text stehen dabei auch Elementnamen, Attribute, IDs und Hierarchien für die Analyse zur Verfügung.
2. Matching vor Differencing
Die zentrale Frage lautet zunächst: Welcher Knoten in Version A entspricht welchem Knoten in Version B? Ein verschobener Absatz soll möglichst als derselbe Inhalt erkannt werden und nicht nur als unabhängige Löschung und Neueinfügung.
3. Mehrere Matcher kombinieren
Der QBK XML Differ arbeitet nicht mit einem starren Vergleichsalgorithmus, sondern mit einer flexiblen, modularen Matcher-Pipeline. Je nach Dokument können unterschiedliche Vergleichsstrategien eingesetzt und kombiniert werden:
- ID-Matching über xml:id oder id
- Matching identischer Inhalte
- Kontext und Geschwisterbeziehungen
- Titel und Abschnittsstrukturen
- Tabellen und Tabellenzellen
- Absatz-Ähnlichkeit
- Inline-Matching
- Attribut-Matching
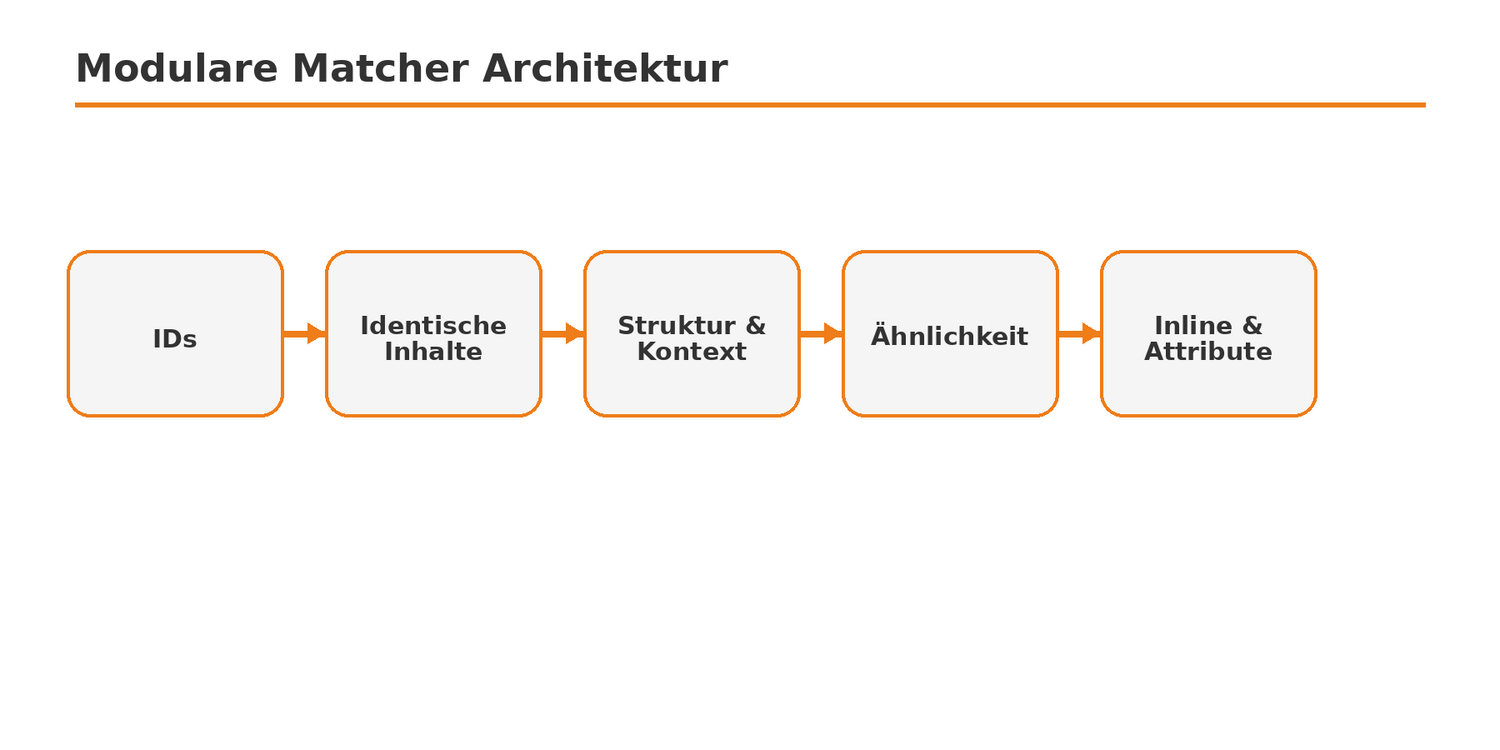
Dadurch lässt sich die Vergleichs-Engine an verschiedene XML-Strukturen und fachliche Anforderungen anpassen. Je nach Projekt können beispielsweise IDs, Text-Ähnlichkeiten, Container-Strukturen, Reihenfolgen, Verschiebungen oder Inline-Fragmente unterschiedlich berücksichtigt werden.
4. Änderungen bestimmen
Sind die Beziehungen hergestellt, kann zwischen unveränderten, geänderten, hinzugefügten, entfernten und verschobenen Inhalten unterschieden werden.
5. Strukturiertes Ergebnis
Das Ergebnis des Vergleichs ist ein annotiertes XML-Dokument. Dieses kann anschließend für verschiedene Ausgaben genutzt werden – insbesondere für das zentrale Anwendungsszenario: ein PDF mit sichtbaren Änderungen aus beiden Versionen.
Der QBK XML Differ für Ihre Dokumente
Sie möchten wissen, welche Matching-Strategien für Ihre XML-Struktur sinnvoll sind? Wir analysieren gemeinsam mit Ihnen ein typisches Dokumentpaar.